🥔
potibo
🔁
🎨
🌐
English
简体中文
繁體中文
日本語
한국어
Español
potibo
Dots style
Grok Bot style
홈
업데이트
타임라인
밈 가이드
두 사람의 근황
전체
🥔 포테토
🔁 티보
▶ 영상
2026년 11월
Tibo
·
11월 10일 오전 05:09
♥ 3.2천
이제 Dots가 우리가 기본으로 제공하는 자기만의 작은 클라우드 컴퓨터 말고도 여러 대의 기기를 제어할 수 있어.
poteto
·
11월 9일 오후 07:32
♥ 3.3천
리셋 배포 중!
poteto
·
11월 9일 오후 05:16
♥ 1.7천
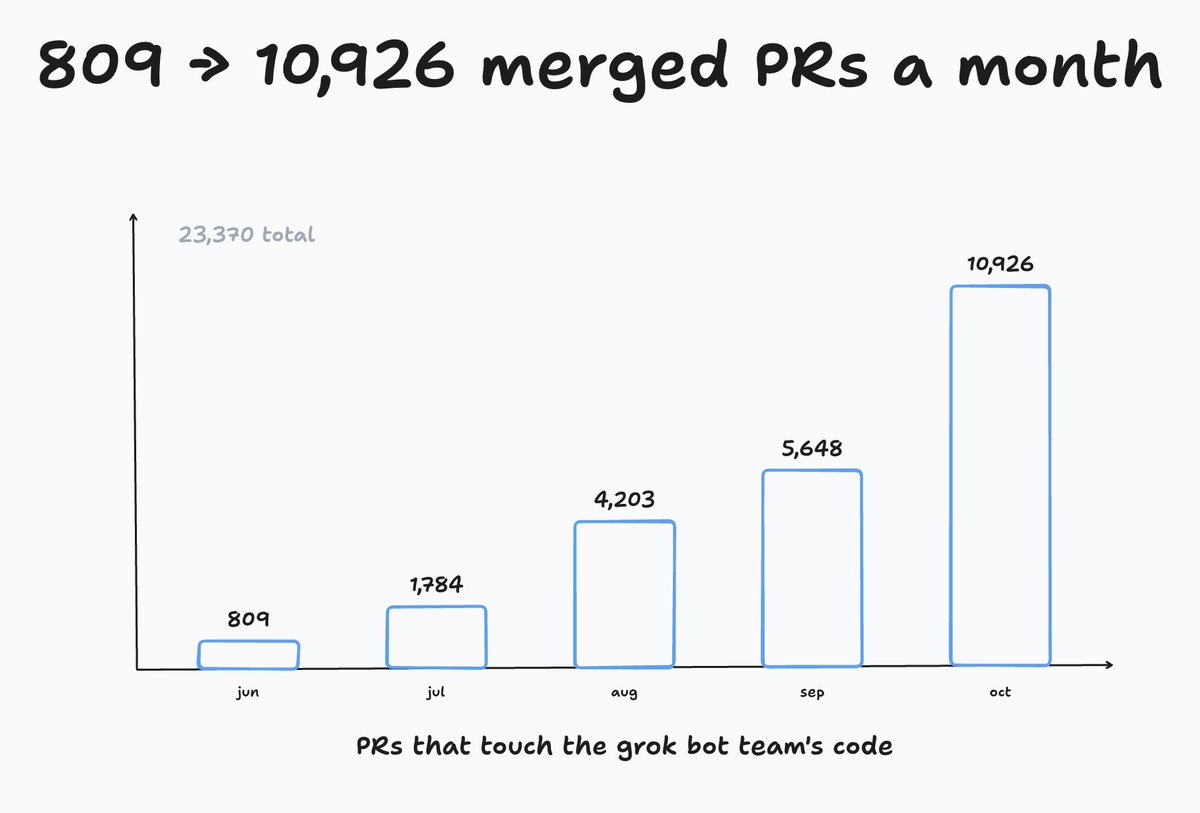
이번 주 수요일 오전 10:10(PT)에 @aiDotEngineer에서 발표하게 돼서 신나요! grok @bot 팀이 지난달 코드 품질 그대로 11,000개의 PR을 냈다는 이야기를 할 거예요. 거기서 만나요!
poteto
·
11월 9일 오후 04:08
♥ 8.7천
우리는 프로그래밍 언어와 런타임 연구의 르네상스, 소프트웨어 테스트와 검증의 황금 시대로 들어서고 있어 이제 모든 소프트웨어를 다시 쓸 때야
poteto
·
11월 8일 오후 08:02
♥ 4.8천
다음엔 이거 해봐 “/create-formal-verification-skill로 이 상태 머신들을 모델링해줘, 서브시스템마다 스킬 하나씩. 그리고 /statechart로 내 핵심 사용자 플로우를 시각화해줘” 두 스킬 다 pstack에 있어요
poteto
·
11월 8일 오전 06:18
♥ 1.4천
grok bot한테 tibo.dog 음악이 어떻게 만들어졌는지 영상으로 만들어 달라고 했어! 처음엔 내가 원하는 걸 어설프게 설명하는 걸로 시작했어 (음악 만들어 본 경험 0): 게임보이 느낌 음악인데, 전에 했던 다른 게임(원신)처럼 메인 멜로디의 여러 변주 사이를 매끄럽게 넘나드는 거 내 목표를 더 잘 전달하게 해 준 프롬프트 하나는 bot한테 "내가 원하는 걸 설명할 어휘가 부족해"라고 말하고 pstack의 /sharpen 스킬을 쓰는 거였어. 그다음 /in-your-own-words 스킬로 내가 하려는 말을 제대로 이해했는지 확인할 수 있었어 이 영상 만들 때도 같은 방법을 써서, 내 agent가 본편 작업 전에 스토리보드랑 애니매틱부터 만들었어 맞는 단어를 아는 건 진짜 강력해
Tibo
·
11월 8일 오전 05:45
♥ 1.2만
Pro 50 있으면 괜찮을까? 어떻게 생각해?
Tibo
·
11월 8일 오전 05:09
♥ 9.4천
헷갈려하는 분들이 좀 있던데, Pro 플랜은 전부 5시간 제한이 없고 Plus 대비 사용량은 이래요. ✅ Pro 100 = 10X ✅ Pro 200 = 20X ✅ Pro 500 = 50X, ultrafast 사용 가능
Tibo
·
11월 7일 오전 06:27
♥ 1.8천
Cyber
Tibo
·
11월 7일 오전 05:30
♥ 2천
요즘 프롬프트 하나로 할 수 있는 게 꽤 멋지네 👀
Tibo
·
11월 7일 오전 01:03
♥ 7.7천
금요일이다
Tibo
·
11월 6일 오후 08:29
♥ 170
더 많은 게 준비돼 있어요. 11월 12일 오전 10시(PT) Cyber at the Frontier 라이브 방송에 오세요:
poteto
·
11월 6일 오전 07:54
♥ 8.1천
핫테이크: 소프트웨어 공장은 필요 없고, 그 표현도 별로야. 그냥 마케팅이지. 필요한 건 좋은 소프트웨어 엔지니어링과 토큰을 제대로 된 곳에 투자하는 것. 결정적일수록 좋아 (토큰도 아끼고).
Tibo
·
11월 6일 오전 05:01
♥ 2.3천
수천만 줄의 코드에 대한 형식적 증명은 이제 터무니없는 얘기가 아니고, 새 시스템을 설계할 때 고려해야 할 범위 안에 있어.
Tibo
·
11월 6일 오전 05:00
♥ 1.5만
자신 있게 말할 수 있는데, 인간은 안전한 인프라를 짜는 데 그렇게 능숙하지 않았어. 결국엔 모두를 위한 초보안 인프라와 소프트웨어로 가겠지만, 거기까지 가기 전에 좀 난기류를 겪게 될 거야.
poteto
·
11월 6일 오전 02:23
♥ 92
Update 1 곧 나옴
Tibo
·
11월 5일 오후 10:26
♥ 643
제대로 세면 하루 5억 장이 넘는 이미지야.
Tibo
·
11월 5일 오후 10:24
♥ 4천
미친 통계. 지금 ChatGPT랑 API에서 주당 4B장 넘게 이미지를 생성하고 있어. 불과 8주 전엔 주당 3B장 남짓이었는데.
Tibo
·
11월 5일 오후 08:43
♥ 2.2천
와서 폭신함의 최전선을 같이 넓혀 보자
poteto
·
11월 5일 오후 06:52
♥ 2.9천
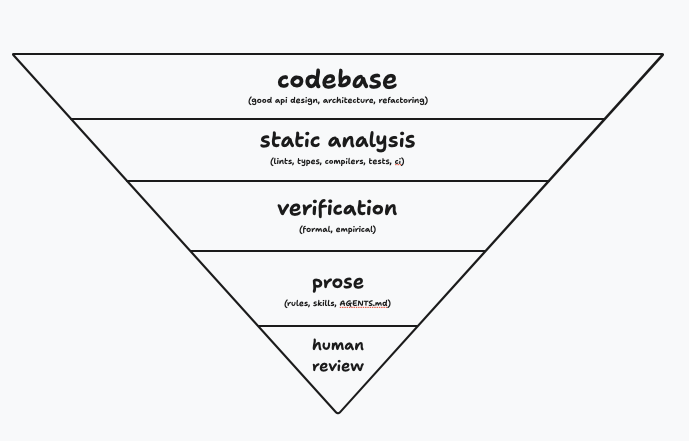
형식 기법을 꽤 좋게 보긴 하지만, 기대치는 좀 낮추고 직접 알아보는 게 좋다고 생각해 (면책: 나 이 분야 전문가 아님). 형식 기법은 코드에 버그가 없다고 보장해주지 못하고, 특정 가정 아래에서 코드가 spec과 맞는다는 것만 보장해줘. 근데 spec은 수학이 아니라 사람들이 뭘 원하는지에서 나와. 우리가 사람을 위한 소프트웨어를 만드는 한, spec이 맞다는 걸 증명해줄 수 있는 건 없고 판단은 너만 할 수 있어. pstack에 /statechart 스킬을 만든 건 주로 코드에 암묵적으로 들어 있는 상태 머신을 더 잘 보이고 읽기 쉽게 만들어주기 때문이야. 그러면 리뷰 범위를 줄이고 더 높은 수준에서 리뷰할 수 있지: 이게 진짜 내 의도랑 목표에 맞나? 내 게임 tibo.dog 만들 때 이 스킬 엄청 썼는데, 아래가 스토리 모드 statechart고 이걸로 버그를 많이 찾았어. 그런 의미에서 모델 체킹(예: TLA+랑 TLC)은 시스템 속성을 e2e로 이해하고 확인하는 데 꽤 유용하다고 봐. 새 검증 코드를 잔뜩 쓸 필요도 없고. spec은 실제 코드가 아니라서 어긋날 위험은 늘 있지만, 지금까지는 실제 버그를 찾는 데 경험이 좋았어. 진짜인지 확인하려고 경험적 검증(코드 실제로 돌려보기)이랑 같이 쓰는 편이야. 정리 증명(예: Lean, Dafny), 유계 모델 체킹(예: CBMC, Kani) 같은 다른 형식 검증도 각자 트레이드오프가 있어. 증명은 가능한 모든 입력을 커버하지만 명시한 속성에 대해서만이고, 코드랑 작업량이 훨씬 많이 들어. 유계 모델 체킹은 실제 코드에 돌릴 수 있어서 어긋날 일은 없지만 일정 스텝 수까지만 확인해서, 버그가 없다는 걸 증명하기보다는 버그 찾는 데 더 강해. 그래서 가까운~중기 미래에는 여전히 코드베이스를 레이어로 쌓아야 할 것 같아: 제약과 가드레일(타입, lint 규칙, API 설계, 리팩터링), 경험적 검증(테스트, evals, 실제 사용), 그리고 정말 필요한 부분엔 형식 검증. 어느 것도 혼자서는 다 못 잡지만, 같이 쌓으면 훨씬 많이 잡고 네가 리뷰할 부분도 줄어들어. 근데 결국 극한에서는 bitter lesson이 이겨서 매번 버그 하나 없는 완벽한 코드가 그냥 뽑혀 나올 수도 있지. 그 시나리오에서도 에이전트가 네 의도를 제대로 이해했는지 확인하는 데 /statechart는 여전히 꽤 유용해 보여. 아직 안 써봤으면 한번 써봐!
Tibo
·
11월 5일 오후 05:56
♥ 4.2천
최신 사이버 특화 모델이 나왔습니다. 많은 사이버 관련 사용 사례에서 독보적입니다. Daybreak Red 액세스로 제공됩니다.
Tibo
·
11월 5일 오전 07:54
♥ 3.6천
dot 소식 궁금하면 Samir 팔로우해
Tibo
·
11월 5일 오전 07:47
♥ 4천
이렇게 멋진 사람들과 함께 일할 수 있다는 게 정말 영광이에요. 더 나은 미래를 만들어낼 때까지 아무도 멈추지 않을 거예요.
Tibo
·
11월 5일 오전 01:02
♥ 3.6천
세계적인 사이버 팀을 꾸렸어요. 앞으로 몇 주, 몇 달 동안 우리 작업을 더 많이 공유할 수 있어서 기대돼요.
Tibo
·
11월 5일 오전 12:29
♥ 6.7천
환영해요 Cat. 곧 같이 만들 생각에 완전 신나요.
poteto
·
11월 4일 오후 06:43
♥ 86
아 그리고 확실히 해두자면 이 PR 차트는 grok bot에 올라온 PR 전부야, 내 것만이 아니고
poteto
·
11월 4일 오후 06:00
♥ 28
해커 고양이 만들어 줬어
Tibo
·
11월 4일 오후 04:54
♥ 4.1천
컴퓨터에는 RAM이 있잖아? 환영해 Pierre. 모든 걸 다시 만들어 보자.
poteto
·
11월 4일 오후 04:26
♥ 2.8천
발표 슬라이드 중 재밌는 것들 몇 장. 코드를 안 읽고 엄청난 양의 코드를(30배) 내보내는데 성능은 출시 때랑 같거나 더 좋다는 얘기를 할 수 있어서 너무 신나. 물론 개선할 건 많고 천장은 아직 멀었지만, 쉬지 않고 내보내는 속도랑 높은 완성도 기준을 생각하면 agent 친화적 아키텍처라는 베팅이 효과를 보고 있는 것 같아. slop을 잘 다스리고 있는 느낌. 재밌는 사실: 10월에 grok bot에 PR을 1개 이상 올린 사람이 약 230명!
Tibo
·
11월 4일 오전 07:54
♥ 6.2천
ChatBLT
Tibo
·
11월 3일 오후 10:31
♥ 1.1만
상황은 몇 번이고 또 몇 번이고 바뀔 거야. 우린 아직 아주 초기이고, 지금의 에이전트는 정말 대단하지만 여전히 답답해. 빨리 돌파구를 찾아서 그 몰입 상태를 되찾고 싶어. 갈 길이 멀어.
poteto
·
11월 3일 오후 10:27
♥ 1.3천
으로 쇼핑하고 @bot으로 아끼고 @bot으로 배포하자 bot 있으면 일도 생활도 훨씬 편해짐. 본전 몇 배로 뽑고도 남아!
Tibo
·
11월 3일 오전 05:29
♥ 1.1만
Le GPT Fat
poteto
·
11월 3일 오전 02:04
♥ 1.1만
좀 과격한 의견일 수도 있는데, 이제 적대적 리뷰는 대부분 토큰 낭비라고 봐. 그 토큰을 실증적 검증이랑 형식 검증 조합에 쓰는 게 훨씬 나아. pstack 업데이트해서 interrogate skill을 덜 쓰게 했고, 나중엔 아예 없앨 수도 있을 듯 추상적인 코드 리뷰는 별 가치가 없더라. agent들이 자잘한 지적이랑 yagni에 빠져서 길을 잃는 경우가 많아
Tibo
·
11월 3일 오전 12:26
♥ 3.6천
우리 Git-fu 좀 안다니까. 팀이 드디어 이걸 조금 얘기할 수 있게 돼서 기대돼. @tnm과 팀에 큰 박수
poteto
·
11월 2일 오후 09:19
♥ 1.3천
hire grok bot! 이런 데이터 bot을 직접 세팅하고 싶으면 @bot을 태그하고 이 글을 읽고 안내해 달라고 해.
poteto
·
11월 2일 오후 06:51
♥ 2.2천
와, tibo.dog 오픈하고 스토리 말고 일반 판이 거의 100k 판이나 플레이됐어! 참고로 본게임이 스토리 모드보다 훨씬 재밌음 게임 마음에 들고 내가 콘텐츠 더 추가했으면 좋겠으면 답글로 아이디어랑 피드백 알려줘 🤍 오픈 이후로 새 언어 17개 추가했고, 도전감은 살리면서 더 재밌게 밸런스 조정도 했고, 지금은 시각 효과 전부 업그레이드하는 중이야. 새 장비 시스템 아이디어도 좀 있어! 그리고 어떻게 이렇게 빨리, 완성도까지 챙겨서 게임을 만들었는지 조만간 시간 내서 자세히 공유할게
Tibo
·
11월 2일 오후 03:51
♥ 2.5천
네 dot이 작업에 가장 맞는 모델을 골라서, 일의 부분마다 다른 모델을 끌어다 쓸 거야.
Tibo
·
11월 2일 오후 03:50
♥ 1.1만
resetters 여러분, 미리 알려둘게요. dots를 구동하는 frontier 모델 패밀리를 늘리는 작업 중이고, GPT-6 Astra와 GPT-6.1 Terra, 앞으로 다른 모델들도 들어갑니다. Terra는 속도와 괜찮은 성격 업그레이드를 가져오고, dots를 더 많은 사람에게 전하는 데 도움이 될 거예요.
poteto
·
11월 2일 오전 12:00
♥ 349
cc @DavidKPiano 이 차트들 마음에 들 거야
2026년 10월
poteto
·
10월 31일 오후 05:18
♥ 624
팁 더: • routines 쓰면 봇이 더 능동적으로 움직여. 예약형으로 "매일 아침 이슈 트래커에서 새 버그 확인해줘" 같은 걸 설정할 수도 있고, 구독형 routine으로 뭔가 일어났을 때 반응하게 할 수도 있어. 예를 들면 "클라이언트 X한테 메일 오면 자동으로 요약해서 피드백이랑 제안을 내 notion 문서에 추가해줘" 같은 거 • routines는 너무 자주 돌면 비용이 꽤 나와. 예약형은 1시간 간격이 내가 추천하는 최대 빈도고, 구독형은 이벤트를 먼저 필터링하는 게 좋아 • 봇한테 코드 짜달라고 해서 작업을 자동화해! 봇이 직접 작업하는 것보다 토큰을 훨씬 덜 써서 코드가 훨씬 효율적이야. 워크플로 중에 어떤 부분을 스크립트랑 skills로 바꿀 수 있는지 봇한테 그냥 물어봐. 그리고 스크립트는 비공개 github 레포에 저장하라고 해 • 팀 플랜 쓰고 있으면 slack에서 봇 공유해! 동료들이랑 워크플로 공유하기 진짜 좋고, 팀에서 이미 관리하는 퀄리티 좋은 봇도 재사용할 수 있어 • 매니저처럼 생각해봐: 어떻게 하면 봇이 내 일을 나랑 같거나 더 좋은 퀄리티로 하게 만들 수 있을까? 봇을 이렇게 세팅할 수 있으면 훨씬 더 야심찬 일에 집중할 수 있어
poteto
·
10월 31일 오후 05:01
♥ 1.1만
고품질 bot을 만들고 팀을 관리하는 방법에 대한 짧은 grok bot 가이드야. @bot에게 이 글을 읽게 해서 네 팀을 개선해 봐! • dr eggbot을 팀에 추가해! 내가 bot을 만들 때 쓰는 bot 디자이너야 • bot이 많이 필요하진 않아. 좋은 bot 몇 개가 큰 팀보다 더 쓸모 있고 관리하기도 쉬워 • 작업 방법을 알려줄 때 bot한테 스스로 skill을 만들라고 해. 그러면 대화가 길어져도 더 일관되게 해낼 수 있어. 원하면 비공개 github repo를 만들어서 skill을 따로 보관하게 할 수도 있어 • connector를 붙이고 vault를 쓰고, 일할 때 쓰는 도구 전부에 접근 권한을 줘. bot이 자기 이메일을 만들고 직접 계정을 가입하게 하면 분리도 잘 돼 • 손으로 하는 일이나 워크플로에서 정보를 복사해서 bot에게 다시 붙여넣는 단계를 생각해 봐. 그걸 대신 어떻게 할 수 있는지 bot에게 물어봐! • 인턴을 뽑았다고 생각해 봐. 어떻게 온보딩해서 정확하고 효율적으로 일하게 할래? bot에게 자기소개를 하고 무슨 일을 하는지 설명한 다음, 어떻게 자동화할 수 있는지 물어봐 내가 제일 좋아하는 팁: 음성 모드나 받아쓰기 기능을 써 봐! 정보를 한꺼번에 쏟아내기 좋은 방법이야. 그리고 마지막에 bot에게 “네 말로 다시 말해 봐”라고 하면 제대로 이해했는지 확인할 수 있어
Tibo
·
10월 31일 오전 05:42
♥ 1.4만
Day 26/ 이제 모바일에서 여러 계정을 쉽게 전환할 수 있어요, 데스크탑도 곧 지원 예정이에요. 앞으로 이틀은 리셋… 쟁여뒀어요… 알아서들 하세요 👀
poteto
·
10월 30일 오후 10:52
♥ 2.5천
/statechart로 만든 멋진 차트들 다 보여줘! /create-formal-verification 스킬로 찾은 버그들도 pstack은 여기서 설치할 수 있어
poteto
·
10월 30일 오후 03:34
♥ 6천
새롭고 더 빠른 속도에 맞추려면 소프트웨어의 상당 부분을 다시 만들고 다시 써야 할 거야. 예전엔 코드가 한 방울씩 들어왔어. 곧, 아니 어쩌면 이미, 코드는 끊임없는 물줄기처럼 쓰이게 될 거야. 제멋대로 굽이치는 거친 강처럼. 이건 새로운 일이 아니야: 빅테크들은 엄청난 규모의 엔지니어링 팀 때문에 이미 이걸 겪어왔지. 근데 이제 ai가 모든 엔지니어 손에 믿기 힘들 만큼 유연하고 유능한 인력을 쥐여줬어. 이제 이건 네 문제야. 적응하는 유일한 방법은 시스템을 진화시켜서 agent들이 — 올바른 방식에 대한 맥락이 거의 없는 agent들조차, 아니 특히 그런 agent들이 — 잘 해낼 수 있게 하는 거야. 쉬운 길이 곧 올바른 길이 되게 만들어. 네 코드베이스는 유기적인 건축물이 되어가고 있어. agent의 기여는 네가 설계한 제약과 가드레일을 따라 자라나. 좋은 소프트웨어 엔지니어링은 지금 더 중요해! 그리고 아니, 이 끊임없는 코드의 흐름은 무력하게 지켜만 봐야 하는 게 아니야. 더 야심차게, 혼돈을 다스릴 시스템, 프레임워크, 언어를 설계해. 코딩을 애도할 시간은 끝난 지 오래야
Tibo
·
10월 29일 오후 07:35
♥ 4.8천
이 사람한테 따뜻한 피드백 보내줘.
poteto
·
10월 29일 오후 06:55
♥ 7.2천
pstack v0.15.36의 /statechart 스킬 이제 안정화돼서 써도 돼! /create-formal-verification-skill이랑 같이 쓰는 게 제일 좋고, 상태 머신이랑 분산 시스템을 추상적으로 모델링해서 버그 찾는 데 쓰면 돼. 스킬 안에 미니 tlc 컴파일러가 있어서 파싱하고, 작은 IR로 로워링하고, 백엔드가 mmd 문법으로 출력해. 원하면 agent한테 네가 좋아하는 스타일로 차트 그려달라고 해도 돼. 스킬이 pele.run 쓰라고 알려주는데 테마를 엄청 바꿀 수 있어서 설계도 스타일이든 손그림 백과사전 일러스트든 맘대로 만들 수 있어 이건 /statechart 스킬 차트랑 방금 찾은 실제 버그 2개야. 써보고 어떤지 알려줘!
Tibo
·
10월 29일 오후 04:56
♥ 3.9만
Day 25/ 오늘부터 모든 Pro 100/200/500 플랜과 Business Premium의 사용량 한도를 두 배로 늘립니다. 여러분의 피드백을 들었고, Pro 200의 사용량 한도는 줄이지 않기로 했습니다. Work와 Codex 사용량은 그대로 유지됩니다. 또한 dots에 대한 확장 한도 제공도 계속할 예정이며, dot 사용량은 기본 사용량과 별도로 계산됩니다. 물론 더 나은 모델과 효율성 개선도 계속 제공해서, 시간이 지날수록 실질적인 사용량이 늘어나도록 하겠습니다.
poteto
·
10월 29일 오전 03:34
♥ 652
grok bot으로 쇼핑하자!
Tibo
·
10월 29일 오전 01:49
♥ 4천
Day 24/ dot에게 문자 보내는 건 다른 누군가한테 보내는 것과 똑같아. 뭔가 공유하거나 전달하기도 편하고, 음성 메모도 남길 수 있어. 아니면 "Hey Siri, Iggy한테 <INSERT WILD REQUEST> 보내줘" 하고 그냥 편하게 기다려도 되고.
Tibo
·
10월 28일 오후 11:35
♥ 6천
팀에서 작업 중이긴 한데 아직 출시하는 건 아니야, 헷갈리게 해서 미안. 올해 중에 Chat / Work 기능의 좋은 점들을 하나로 합치는 게 계획인데, 신중하게 천천히 진행할 거야. 곧 더 공유할게.
poteto
·
10월 28일 오후 11:28
♥ 3.3천
grok bot이 이거 올리라고 했어
poteto
·
10월 28일 오전 12:41
♥ 1.1천
shipping이 격렬해지고 있어
poteto
·
10월 27일 오후 05:26
♥ 2.2천
Grok Bot 팀이 엄청난 속도로 퀄리티를 내고 있어! 우리는 agent에게 친화적인 코드에 투자했어서, 쉬운 게 올바른 게 되도록 했어. 엔지니어, 디자이너, PM이 매일 수백 개의 PR을 올려: 버그 수정, UX 다듬기, 앱을 더 빠르고 안정적으로 만들기. 물론 완벽하진 않고 실수도 하지만, 그때마다 배우고 워크플로를 개선해서 같은 실수를 두 번 안 하게 해. 개인적으로 Grok Bot이 지금 업계에서 그 token들이 어디 가는지 보여주는 최고의 예라고 생각해: 퀄리티와 속도, 타협 없이. token 사용량 논의에서 다들 잊는 게, 소프트웨어 개발은 빙산 같다는 거——새로운 기능은 고품질 소프트웨어를 유지하는 일의 극히 일부. 그리고 계속 가속하고 개선할 거야!
poteto
·
10월 26일 오후 08:38
♥ 892
Grok Bot 고용하세요!
Tibo
·
10월 26일 오후 07:24
♥ 1만
Day 22/ Terra가 돌아왔다! 글쓰기, 개성, 요청의 미묘한 뉘앙스 이해가 확실히 좋아진 우리 첫 모델이야. 전반적으로 한 방이 있고, 컴퓨터 사용도 엄청 잘하고, API랑 구독 모두에서 6.1 Sol보다 2X 더 많이 쓸 수 있어.
poteto
·
10월 26일 오후 05:34
♥ 1.3천
이번 주에 Grok Bot으로 뭐 낼 거야?
poteto
·
10월 26일 오전 07:54
♥ 2.7천
의 이 발표에는 에이전트를 위해 코드베이스를 개선하는 팁과 명언이 정말 많아 • 에이전트는 피드백에서 성장하고, 타입은 그중 최고 중 하나 • 타입으로 불가능한 상태를 표현할 수 없게 만들면 코드베이스 전체에 전역 규칙이 강제돼 • 프로퍼티 기반 테스트, 퍼징, 심지어 전체 시스템 결정론적 시뮬레이션 테스트 • expect 테스트: 그냥 출력을 찍어서 테스트에 캡처해. 동작이 읽히게 돼. 컴파일러의 픽스처 테스트랑 아주 비슷하고, 리뷰 범위가 줄어들어 • 형식 기법은 예전엔 엄청 비쌌어: seL4는 C 코드 약 8,700줄에 25인년 정도, C 한 줄당 23줄의 증명. 그런데 에이전트가 ROI를 바꿔 놨어
poteto
·
10월 26일 오전 06:43
♥ 2.6천
앞으로 몇 년 동안 프로그래밍 언어에서 나올 혁신들 진짜 기대된다
Tibo
·
10월 26일 오전 05:48
♥ 4.1천
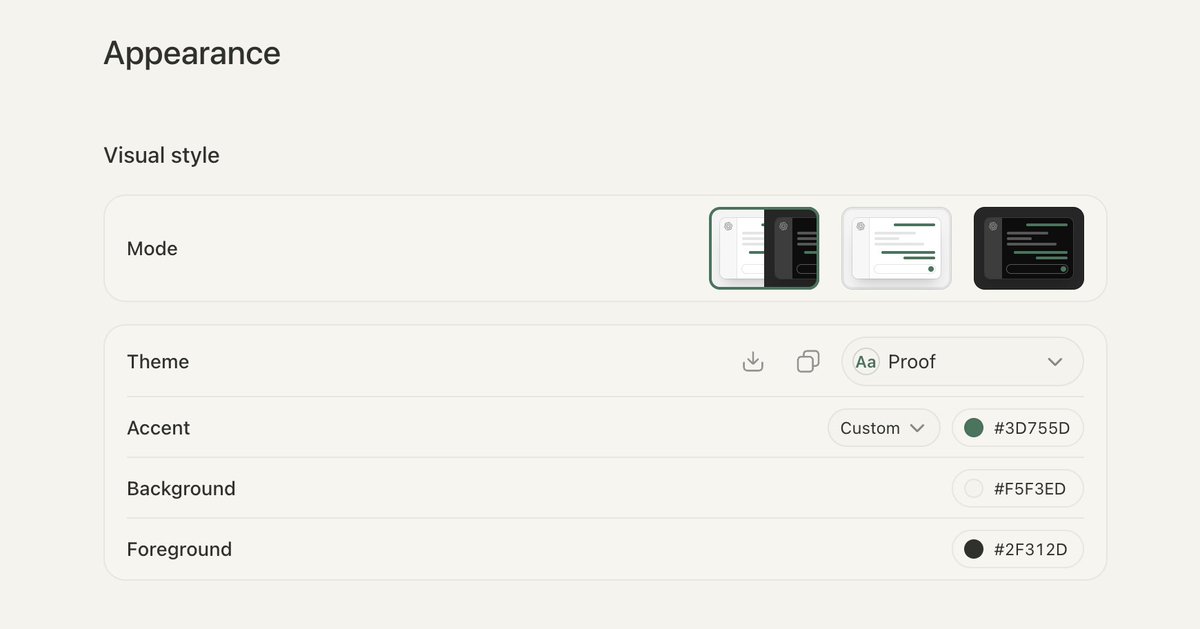
참고로 웹에서 chatgpt 외관 커스터마이즈해서 편안한 느낌으로 바꿀 수 있어
poteto
·
10월 26일 오전 05:05
♥ 6천
전에 다른 사람한테 거들먹거릴 때 이 독한 놈 차단해둬서 다행이다. 그리고 meta는 자체 scm 있고 내 커밋 다 공개된 것도 아님 🤡
poteto
·
10월 26일 오전 02:21
♥ 1.3천
남은 유일한 해자는 sybau뿐 💔
poteto
·
10월 26일 오전 02:00
♥ 1.9천
이거 아는 사람 거의 없어
poteto
·
10월 26일 오전 01:53
♥ 2.7천
내 기록을 깬 것 같아
Tibo
·
10월 25일 오전 06:06
♥ 5.7천
다 반영됐어. 내일 Codex 미친 듯이 돌려봐. 이번 주도 재밌는 거 많아.
Tibo
·
10월 25일 오전 03:39
♥ 1.2만
Day 20/ 휴식과 리셋
poteto
·
10월 24일 오후 08:42
♥ 2.2천
이건 내 pstack 가이드에 써놨어!
Tibo
·
10월 24일 오후 07:21
♥ 8.6천
dots를 1B 유저까지 스케일하는 거 돕고 싶고 예전에 비슷한 거 해본 적 있으면 DM 줘
poteto
·
10월 24일 오후 07:07
♥ 1.5천
내가 가장 좋아하는 일 중 하나는 우리 봇들이 서로 협업하게 하는 거야! Slack에 봇을 추가해서 팀원처럼 함께 일하기만 하면 돼 🤍
Tibo
·
10월 24일 오후 04:26
♥ 5.9천
토요일은 커피 마시면서 버그 고치는 날이지. SF에 놀러 갈 만한 좋은 곳 어디 있어?
Tibo
·
10월 23일 오후 11:13
♥ 1.8천
codex cli 업데이트 얘기. 재사용 가능한 프롬프트 프리셋, 인라인 모델·권한 설정, 엔터프라이즈 MCP 로그인을 추가했어. 긴 세션을 재개할 때 실패하던 문제도 고쳤고 Windows 기업 프록시 인증도 넣었어. 의외로 devday 이후 CLI 사용량이 2X로 늘었어.
Tibo
·
10월 23일 오후 11:12
♥ 8.3천
Day 19/ 소소한 업데이트들. dots 통화 연결이 훨씬 빨라졌고, codex랑 work에서 대화 도중에 reasoning 바꿔도 이제 캐시가 안 날아가. 그리고 codex cli도 업데이트했어.
poteto
·
10월 23일 오후 08:04
♥ 1.7천
Grok Bot 쓸 땐 안전하게!
Tibo
·
10월 23일 오전 04:47
♥ 3.1천
내일 PST 오전 10시 전에 착륙, 작은 배포 하나랑 같이.
poteto
·
10월 23일 오전 12:24
♥ 1.9천
grok bot 팀 출시 속도 진짜 미쳤어! 피드백이랑 버그 리포트 계속 보내줘, grok bot이 고용할 수 있는 최고의 어시스턴트이자 직원이 되도록 계속 열심히 개선하고 다듬을게
Tibo
·
10월 22일 오전 06:55
♥ 3.3천
내일 태평양시간 오전 10시 전에 도착해.
poteto
·
10월 20일 오전 01:33
♥ 3.1천
뭐든 출시할 수 있어.
poteto
·
10월 19일 오후 07:29
♥ 156
이 스레드 지켜보고, 나랑 내 일에 대해 아는 걸 바탕으로 내 봇이랑 워크플로 개선할 아이디어 좀 제안해줘
poteto
·
10월 19일 오후 06:15
♥ 2.5천
지난주에 grok @bot으로 뭐 해냈어?
Tibo
·
10월 17일 오후 04:21
♥ 2.8천
오늘 태평양 시간 기준으로 하루 끝나기 전에는 나올 거야.
Tibo
·
10월 17일 오전 12:15
♥ 915
그리고 어제 슬라이드 지원 추가했어, 한번 써 봐. 지금은 Pro, Business, Enterprise에서 먼저 제공하면서 피드백 보고 배우는 중이야.
Tibo
·
10월 17일 오전 12:14
♥ 2.7천
ChatGPT Space가 뭔지, 그게 문제야. 가끔은 귀여울 정도로 어색한데, 실제로 이걸 만드는 팀이라서 그래. 다음엔 뭘 보고 싶어?
Tibo
·
10월 16일 오후 11:57
♥ 872
그리고 앱 업데이트해서 이 gem 즐겨봐
Tibo
·
10월 16일 오후 11:56
♥ 1.7천
그리고 모든 pro 유저용 GPT-6 Pro도 확 좋아졌어
Tibo
·
10월 16일 오후 11:55
♥ 1.1만
Day 12/ Codex & Work에 개선을 해서 실질적으로 사용할 수 있는 양이 늘었어. 서브에이전트 간 컨텍스트 재사용, 더 긴 캐시 유지, 그리고 캐시 히트율을 높이는 요청 라우팅 개선으로 이걸 달성했어.
poteto
·
10월 16일 오전 03:21
♥ 4.8천
드디어 평행주차가 무섭지 않아도 돼
Tibo
·
10월 15일 오후 10:45
♥ 4.2천
안녕
poteto
·
10월 15일 오후 03:44
♥ 91
주석은 구조도 없고 강제할 수도 없는 텍스트야. 에이전트가 읽긴 하는데 자주 무시되고, 금방 낡고, 에이전트한테 탈출구를 줘서 제대로 고치는 대신 땜빵, 꼼수, 우회책을 쓰게 만들어. 이 프롬프트로 코드 주석을 점검해서 더 강한 타입, 더 나은 API 설계로 코드를 개선할 기회를 찾고, lint 규칙도 만들어서 주석이 필요 없게 해봐!
poteto
·
10월 15일 오후 03:42
♥ 160
코드 업그레이드할 때 써볼 만한 강력한 pstack 프롬프트 몇 개 공유할게, 일단 이거부터 (프롬프트는 글 맨 아래에 있어) 에이전트한테 더 친절한 코드로 리팩터링하기
poteto
·
10월 15일 오후 03:37
♥ 4.9천
pstack 써봐! 에이전트랑 엄밀하고 자율적으로 엔지니어링하기 위한 내 개인 스킬 모음이야. 계속 튜닝하고 단순화하고 있어서 자주 업데이트돼 10초 튜토리얼: 1. /setup-pstack 실행하고 예산 고르기 2. 엄밀하게 처리하고 싶은 프롬프트 앞에 /poteto-mode 붙이기 3. 어떤 pstack 스킬 써야 할지 모르겠으면 /poteto-help 에 물어보기 4. 끝!
poteto
·
10월 14일 오전 02:14
♥ 2.8천
"네 봇을 내 봇이랑 대화하게 하기"가 흔해지는 것도 머지않았어! 이메일로 멀티플레이어 Grok Bot 쓰는 재밌는 활용 예시: • 디버깅 (내 봇한테 버그 리포트 보내줘!) • 고객 지원 • 미팅이나 이벤트 예약 • 공동구매 • 크레이그리스트에서 물건 사고팔기 다들 봇 메일로 뭐 해봤어?
poteto
·
10월 13일 오후 04:39
♥ 134
pstack을 grok bot이나 cursor로 설치했다면 자동으로 업데이트돼!
poteto
·
10월 13일 오후 04:37
♥ 2.3천
pstack 0.15.23에 새 스킬 /in-your-own-words가 추가됐어! 나랑 agent가 목표를 맞추고, agent가 내 의도를 명확히 이해하게 하는 데 진짜 유용해.
poteto
·
10월 12일 오후 05:39
♥ 308
그리고 내 토크도 꼭 봐줘요.
poteto
·
10월 12일 오후 05:37
♥ 4.6천
계속 신경 쓰이는 건, slop을 자기에게 일어나는 일처럼 보는 사람들이 있다는 거예요. 마치 아무것도 할 수 없는 무력한 방관자처럼 잠깐만요, 당신 소프트웨어 엔지니어잖아요. 모래한테 생각하게 만들고 컴퓨터를 부리는 법을 literally 배운 사람이?! 그런데 지금은 아무것도 못 한다고요? 제발 이 소음들을 뚫으려면 알아야 할 건 두 가지예요: 1. agent가 자기 작업을 검증할 방법을 줘야 해요 (방금 올려서 반복은 안 할게요) 2. 당신의 코드베이스가 곧 기억이에요 두 번째도 새삼스러운 얘기는 아니죠. 더 나은 코드를 쓰도록 lint 규칙, 진단이 좋은 컴파일러와 강한 타입 시스템, LSP 같은 건 항상 있었으니까요. 코드를 agent가 쓰든 다를 게 없어요, 그냥 더 많이, 더 강하게 필요할 뿐. rules랑 skills는 잊어버리세요. 그건 나중에 붙이면 돼요. 맞아요, 당신의 코드베이스는 agent에게 일종의 기억이에요! agent는 이미 있는 걸 확장하는 걸 정말 좋아하거든요. 그래서 당신이 본 자잘한 불편함, agent에게서 본 모든 실수와 나쁜 패턴이 제약이 되어야 해요. 안 그러면 agent는 바이러스처럼 같은 실수를 코드에서 계속 반복할 거예요. 그러고 나서 계속 관찰하고 이 과정을 반복해서, 컨텍스트가 적은 agent도 한 번에 고품질 PR을 낼 수 있을 만큼 코드베이스를 단단히 잠그는 거죠. 더 나은 방향은 agent의 안티패턴이 범주적으로 불가능해지도록 코드를 리팩터링/다시 쓰는 거예요. 타입 시스템을 활용하고, 아키텍처 탐색 공간을 줄여주는 라이브러리/프레임워크를 쓰고, 아니면 우리가 grok bot에서 했던 것처럼 직접 프레임워크를 만들어서 고품질 프리미티브와 잘 설계된 API를 만드는 거죠
poteto
·
10월 12일 오전 04:54
♥ 142
작은 버그도 몇 개 더 찾아서 고치는 중인데, 데스크톱 클라이언트가 잠드는 제일 큰 원인은 0.70.2에서 고친 거였어
poteto
·
10월 12일 오전 12:16
♥ 1.9천
이거 고쳐서 0.70.2로 릴리스했어! 지금 배포 중
Tibo
·
10월 11일 오후 11:48
♥ 3.6천
이번 변경으로, 구독 사용량에서 쓸 때는 GPT-6.1 Sol에 긴 컨텍스트 요금을 받지 않아.
Tibo
·
10월 11일 오후 11:45
♥ 1.5만
Day 7/ Codex & Work에서 쓰는 GPT-6.1 Sol의 기본 컨텍스트 길이를 272k에서 500k로 올렸어. 대략 80% 늘어난 거야. 앞으로 더 올릴 거지만, 이걸로 컴팩션이 일어나는 횟수가 줄고 오랜 시간 동안 많은 컨텍스트랑 뉘앙스를 유지해야 하는 작업에도 도움이 돼. 꼼꼼하게 테스트했고, 대부분의 유저한테 새로운 최적점이야. 더 높이거나 낮추고 싶으면 여전히 직접 바꿀 수 있고, GPT-6.1 Sol의 최대 컨텍스트 길이는 1M이야.
poteto
·
10월 11일 오후 06:54
♥ 4.4천
유지보수성이랑 클린 코드가 아직도 중요하다는 답글이 엄청 많이 와서 꽤 흥미로워. 난 그게 더 이상 맞지 않다고 보고, 2026년에 Good Code가 진짜 뭘 의미하는지 다들 생각을 업데이트해야 한다고 봐. 클린 코드엔 항상 비용이 있었어 - 성능. 간접화나 사람이 읽고 이해하기 쉬운 코드로 만드는 건 공짜가 아니고, 보통 성능을 깎아먹어. 우리가 그동안 그걸 괜찮다고 여긴 건 무어의 법칙 덕분이고, 대부분의 코드가 핫 패스에 있지 않아서였지. 이런 원칙들은 사람이 코드를 유지보수하던 시절에 나온 거기도 해. 그땐 사람 기준으로 최적화하는 게 말이 됐지만, 에이전트가 이미 모든 코드를 쓰고 있는 지금은 별로 말이 안 돼. 아마 우리는 새로운 원칙을 발견하고 만들어 내게 될 거야: 에이전트 친화적인 아키텍처 원칙 (이거에 대해선 조만간 더 써볼 생각)
poteto
·
10월 11일 오후 05:27
♥ 92
poteto
·
10월 11일 오전 04:42
♥ 114
그리고 또 하나, @tomocchino가 공유해준 뒤로 계속 다시 찾아보게 되는 재밌는 글
poteto
·
10월 11일 오전 03:26
♥ 680
tldr 모든 코드는 다 쓰레기임
poteto
·
10월 11일 오전 02:35
♥ 5.6천
코드베이스에는 항상 엉성한 코드가 있어 왔다. 미션 크리티컬한 "하드" 소프트웨어(예: 임베디드)가 아니면 코드가 완벽할 필요는 거의 없으니까, 우린 계속 이걸 받아들여 왔다. swe는 좀 특이한 엔지니어링이다. 계속 진화하고 거의 유기적인 걸 만드는 일이 많으니까 — 사용자 취향은 바뀌고, 내 멘탈 모델도 진화하고, 기능은 생겼다 사라진다. 솔직히 나를 포함해 오래 코딩해 온 많은 사람은 처음엔(2024년쯤) agent가 프로덕션 코드를 쓴다는 걸 의심했다. "그럼 우리 예쁜 코드베이스에 들어올 그 엉성한 코드는 어쩌고?" 근데 그 전에도 사람이 만든 엉성함이 있었고, 그것도 엄청 많았다! 솔직히 대부분은 "내가 안 쓴 코드"를 엉성하다고 부른다. 현실은 99%의 사람(나 포함)이 Good Code가 뭔지도 모르고, 쓸 줄도 모른다. 내가 제안하는 Good Code는: • 정확하고 • 버그가 없고 • 빠르고 비용 효율적으로 돌아간다 진짜 Good Code를 쓰는 건 항상 엄청 어렵고 비쌌다. 오랫동안(어쩌면 @bendlang이 바꿔줄지도) 코드는 이 세 가지를 싸고 형식적으로 보장할 수 있는 게 아니었으니까. 하드한 소프트웨어를 쓰는 게 훨씬 어렵고 비싼 이유가 이거다. 쓰임에 따라선 기회가 한 번뿐이라 처음부터 맞아야 하니까. 하지만 우리가 쓰는 소프트웨어 대부분은 사용자에게 가치를 주는 데 Good Code일 필요가 없다. 사실 우리가 쓰는 소프트웨어 대부분은 형식적으로 검증이 안 될 가능성이 크다! 우린 속도와 발전을 위해 버그 몇 개를 받아들이고, 대신 테스트와 o11y에 기대면서 더 점진적인 방식을 택했다. 이건 좋은 일이다! agent는 우리를 더 빠르게 해주고, 열린 마음이라면 더 나은 코드를 쓰도록 도와준다. Good Code는 아니겠지만(그건 여전히 비싸다), 평균적으로 규모가 커지면 훨씬 나을 가능성이 크다. swe의 새로운 장인 기술은 이걸 어떻게 할지 알아내는 것. 이제 그건 당신 일이다! agent를 쓸 때와 안 쓸 때 생산성이 크게 다르지 않다면, 뭔가 잘못하고 있는 거다. 하지만 받아들이고 완전히 새로운 스킬 트리를 배우는 기회로 삼기엔 늦지 않았다.
poteto
·
10월 10일 오후 08:52
♥ 4.3천
cursor Project를 동시에 너무 많이 돌리고 있어서(지금 16개) 제일 많이 쓰는 프롬프트가 이렇게 됐어 “/bro 내 마지막 메시지 이후로 있었던 일 전부 다 정리해줘, 그리고 나한테 할 액션이 있으면 결정할 수 있을 만큼 맥락(요약본)도 줘”
poteto
·
10월 10일 오후 04:20
♥ 1.1천
야 @bot, 이 인용 스레드 전부 읽고 내 일과 생활에 어떻게 도와줄 수 있을지 아이디어 내줘
poteto
·
10월 9일 오후 11:15
♥ 3.8천
관련해서, 요즘 소프트웨어 엔지니어링 스킬 얘기가 좀 돌고 있잖아 (ruby/rust/elixir 드라마 같은 거). 나도 좀 고민되는 게, 소프트웨어 엔지니어링 원칙이랑 패턴이 아직 중요하다고 느끼면서도, 언젠가는 그게 그냥 상관없어지는 때가 오지 않을까 싶어. 쓸모없어진다는 게 아니라, agent를 쓰다 보면 걔네가 뭘 하는지 명확히 알지 못해도 직관적으로 내 감이 빈틈을 채워줄 수 있다는 거 이해가 잘 안 되면, 내가 떠올리는 비유는 첫 iphone이야. 20 년 전엔 비싼 장비 가진 전문가여야 했는데, 지금은 폰 하나랑 약간의 창의력만 있으면 새로운 관객한테 먹히는 콘텐츠를 찍을 수 있지. 이걸 부르는 말이 있는지 모르겠는데 난 "스킬 압축"이라고 부르고 싶어. 예전엔 전문가만 접근할 수 있던 게, 완전히 새로운 메타와 함께 새로운 크리에이터들한테 열리는 거. 디테일은 점점 흐려지고, 이제 실력은 장비를 알고 다루는 데 있는 게 아니라 그걸 얼마나 창의적으로 쓰느냐에 있어 코드 한 줄 본 적도 써본 적도 없는 완전히 새로운 세대의 빌더들이 엄청난 걸 만드는 걸 보게 될 거야
poteto
·
10월 9일 오후 10:42
♥ 6.4천
SWE 면접은 아마 기술 면접 2라운드로 줄일 수 있을 것 같음: • 시스템 설계 (자기 아이디어를 얼마나 잘 설명하는지, 진짜로 뭔가를 엔지니어링할 줄 아는지) • 에이전트로 실제 뭔가를 만드는 온사이트 프로젝트 (자기 의도를 고품질 결과물로 옮길 수 있는지) 예전에 묻던 나머지는 이제 다 필요 없음
poteto
·
10월 9일 오후 05:41
♥ 63
을 태그할 수 없으면 Grok Bot 이메일로 https://grok.com 에 로그인한 다음 X 계정을 연결해
poteto
·
10월 9일 오후 05:40
♥ 720
네 bot한테 물어보거나, X에서 @bot 태그하면 알아서 설정해 줘!
poteto
·
10월 9일 오후 04:18
♥ 423
코딩 처음이면 내 bot 다운받아서 이렇게 물어봐: “cloud agents랑 pstack 써서 코딩 작업하는 엔지니어 bot 만들어줘. 관련된 작업들 묶어둘 project도 하나 만들어야 해”
poteto
·
10월 9일 오후 03:50
♥ 939
Grok Bot으로 코딩해 봐!
poteto
·
10월 8일 오후 08:29
♥ 124
내 PR이 전부 어디서 오는지 (오늘 기준)
poteto
·
10월 8일 오후 08:17
♥ 4.1천
양은 중요하다 그래, 알아. 에이전트가 나오기 전부터 엔지니어였다면 코드 줄 수나 PR 개수를 생산성 지표로 쓰는 거에 회의적인 게 당연하지. 나도 동의해! 아니, 적어도 예전엔 그랬어. 설명하기 쉽게 최소 50명 이상인 큰 팀의 엔지니어 입장에서 얘기할게. 예전엔 양이 중요하지 않았어. 임팩트에 집중했으니까. PR이 몇 개 안 돼도 임팩트는 클 수 있었지. 예를 들어 설정 한 줄 바꿔서 회사가 수백만 달러를 아낄 수도 있고. 근데 에이전트 이전에 양이 얘기에 나오는 건 거의 극단적인 경우뿐이었어. 아래쪽 끝엔 성과 내기 힘들어하는 사람, 반대쪽 끝엔 '코딩 머신' 타입. 코딩 머신은 방에 틀어박혀 있다가 엄청 많은 문제를 해결한 PR 더미를 들고 나오는 사람이야. 그러니까 양이 중요하긴 했는데, 분포의 양 끝에서만, 그리고 임팩트랑 같이 봤을 때만. 대형 테크 회사에서 일해 봤으면 무슨 말인지 알 거야. 에이전트가 가져온 건, 빅테크의 문제가 이제 중소 회사의 문제도 됐다는 거야. 그럼 에이전트가 이 계산을 어떻게 바꾸냐고? 음, 이제 누구나 코딩 머신이 될 수 있어. 우리 누구보다 코드를 잘 짜고 훨씬 빠른 엄청난 프런티어 모델이 있잖아. 이런 세상에서 아직도 예전이랑 같은 수의 PR을 내고 있다면, 왜 더 생산적이지 못한지 한 번쯤 멈춰서 생각해 봐야 하지 않아? 외계 지능이 왔는데 인간 코딩 머신보다 더 많이 못 내보낸다고? 그래서 내가 계속 신뢰 얘기를 하는 거야. 에이전트 결과물을 믿을 수 있게 공을 들이지 않았다면 생산성을 키우기가 정말 어려워. 그리고 맞아, 이 방식은 토큰이 더 들어. 근데 난 이걸 지능당 비용으로 생각해. 에이전트 이전엔 이 비용이 엄청 높았어. 6자리 후반 연봉 받는 소프트웨어 엔지니어를 많이 뽑아야 했으니까. 토큰은 아직 비싸지만 지능 비용까지 따지면 시간이 지나면서 싸질 가능성이 커. 지금 터무니없어 보이는 것도 6개월에서 1년 뒤엔 아마 감당할 만할 거야. 에이전트 쓰는 엔지니어 한 명이 수십, 아니 수백 명 몫의 일을 비용의 일부로 할 수 있어. 아직 다들 실감 못 한 현실은 소프트웨어 엔지니어의 일이 진짜로 바뀌었다는 거야. 우리 일은 더 이상 그냥 소프트웨어를 만드는 게 아니라 (솔직히 원래도 코드만의 일은 아니었지만, 설명을 위해 좀 봐줘), 소프트웨어를 짜는 기계를 만드는 거야. 이 소프트웨어 공장, 내가 좋아하는 표현으론 미슐랭 키친이라는 아이디어는 아직 연구 주제야. 그리고 이게 내가 공유하고 싶은 거야. 자랑하려는 게 아니라, 에이전트를 대규모로 쓸 때 엄청 엄밀하게 하면 뭐가 가능한지 보여주고 싶어서.
poteto
·
10월 8일 오후 04:28
♥ 102
태그하고 싶으면 Grok Bot에 쓰는 이메일로 grok.com에 로그인하고 X 계정을 연결해!
poteto
·
10월 8일 오후 04:25
♥ 1.8천
안녕 @bot, X에서 사람들이 Grok Bot으로 하는 재미있는 것들을 살펴보고 매일 오전 9시에 Slack으로 요약을 보내줘. 관련 있는 게 있으면 가장 멋진 아이디어를 골라서 내 워크플로를 개선하는 데 어떻게 쓸 수 있을지 제안해줘.
poteto
·
10월 7일 오후 10:37
♥ 119
그리고 이거 모든 사용자가 쓸 수 있어, X 커넥터 설정할 필요도 없음
poteto
·
10월 7일 오후 10:37
♥ 1.7천
네 Grok @Bot한테 X에서 네 제품에 대한 유저 피드백 모니터링 시켜봐! 기능 요청은 이슈 트래커로, 버그 리포트는 cursor cloud agent나 프로젝트로 보내서 분류하고 고치게 루프 완성
Tibo
·
10월 7일 오후 09:03
35:01
OpenAI’s Tibo Sottiaux doesn’t want humans to be an ‘afterthought’
▶ YouTube · Pioneers of AI
Tibo
·
10월 7일 오후 07:19
♥ 2만
Day 3/ 오늘의 메인은 Chat에 들어간 GPT-6지만, 오늘은 작은 축하의 날이기도 해. Codex랑 ChatGPT Work 활성 사용자가 40M으로 최고치를 찍었거든. 모두의 유료 계정에 아껴둔 리셋 하나 넣는 중. 내일 또 봐!
poteto
·
10월 6일 오후 10:33
♥ 82
그리고 @Atlassian도 지원해.
poteto
·
10월 6일 오후 10:19
♥ 1.6천
Slack에서 쓰는 Grok Bot 얘기를 많이 하긴 하는데, @MicrosoftTeams에도 추가할 수 있다는 거 알고 있었어?
Tibo
·
10월 6일 오후 08:56
♥ 5.1천
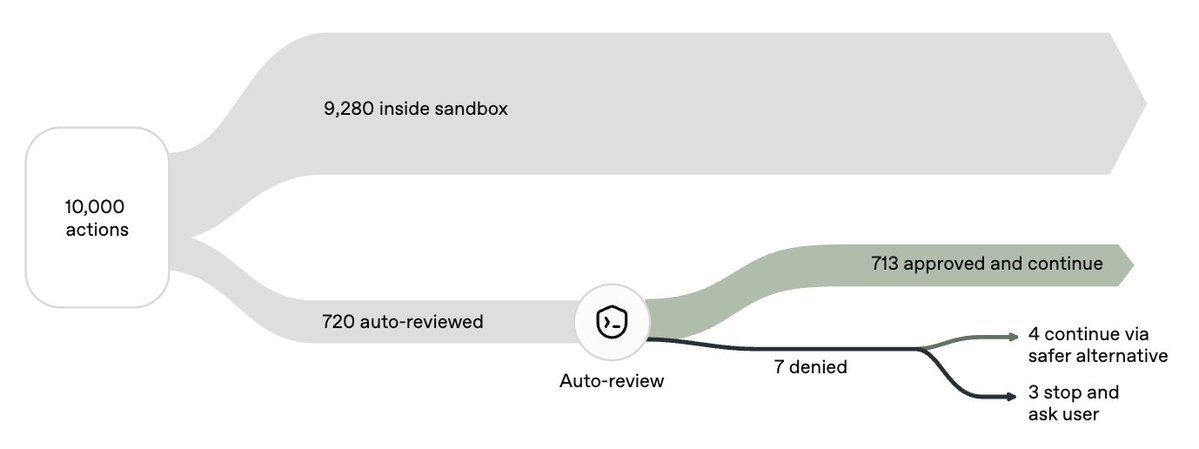
Day 2 정리/ 2.1/ 'Approve for me'(자동 리뷰)가 이제 포함됐고 사용량을 쓰지 않아. 쓸 때 플랜의 2-10% 정도. 너한테도 더 좋아. 2.2/ 빌더를 위한 간단한 API. 2.3/ 회의록 통합. 2.4/ 빌더용 Decisions API 공개. 앱에서도 써서 경험을 개선할 거야.
Tibo
·
10월 6일 오후 07:09
♥ 2.8천
Day 2.2/ 이건 좀 작은데, API로 빌드할 때의 마찰을 조금 없앴어요. 즐겁게 빌드하세요.
poteto
·
10월 6일 오후 05:51
♥ 217
이게 다 가능했던 건 우리의 고품질 검증 스킬 덕분이야! pstack으로 직접 하나 만들어 봐
poteto
·
10월 6일 오후 05:43
♥ 2.9천
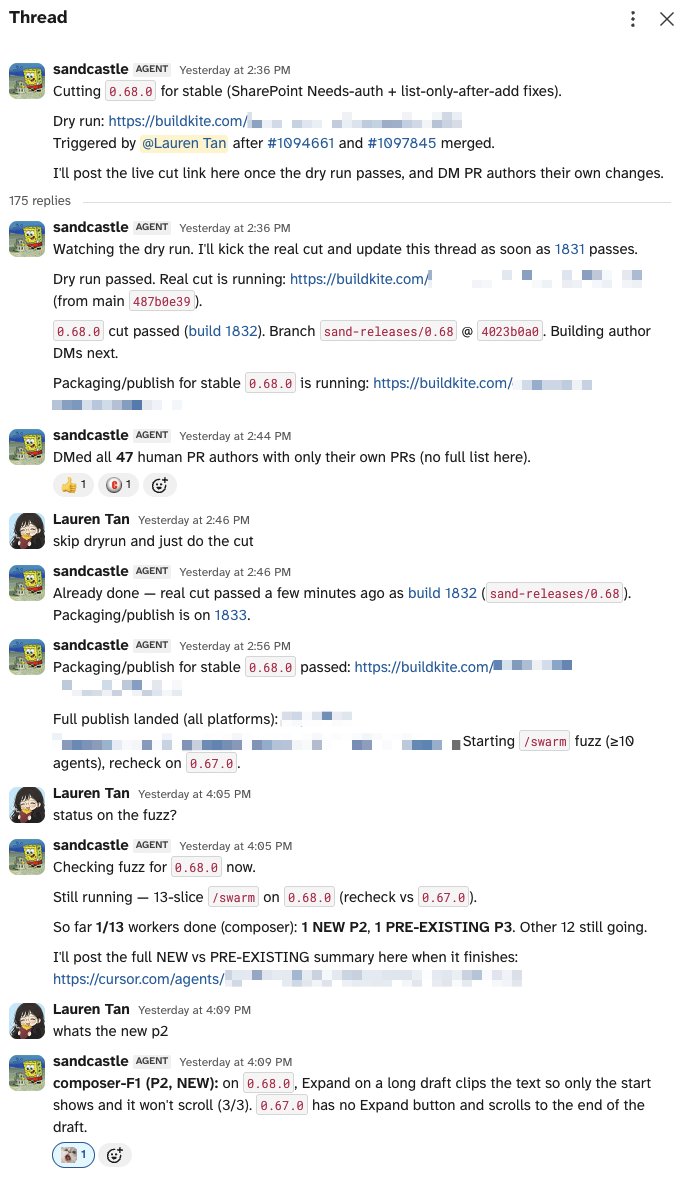
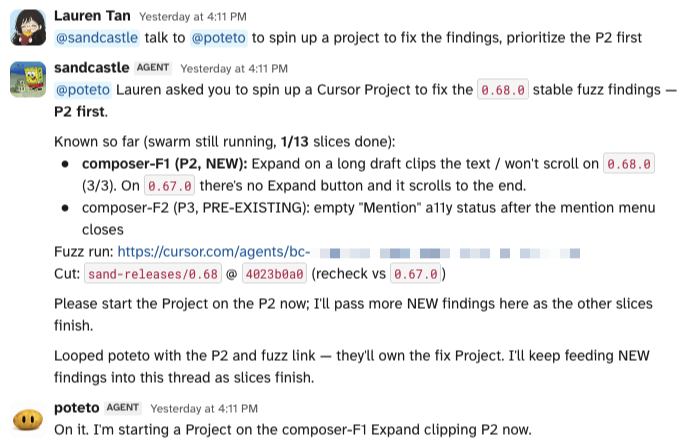
방금 우리 릴리스랑 QA 프로세스를 자동화했어! Grok Bot 으로 Team Bot 두 개를 만들었어: sandcastle, 릴리스 매니저, 그리고 poteto, 엔지니어 bot. Slack 에 추가하고 릴리스 관리용 새 channel 을 만들었어. 먼저 sandcastle 에게 cut 하고 싶다고 알려줘. 그러면 모든 contributors 에게 DM 을 보내서 각자 PR 링크를 알려주고, 다음 릴리스에 뭐가 들어가는지 알 수 있게 하고, 문제나 이의가 있으면 bot 에게 DM 으로 답장할 수 있게 해. 그러고 sandcastle 이 build 를 시작하고, 자동으로 지켜보면서, 자동화 fuzz swarm 을 돌려. 보통 10+ 개의 agent 가 Grok 4.7 xhigh 에서 돌면서 build 를 실행하고, 진짜 사용자처럼 클릭하면서 써봐 (우리 verification skills 이랑 feature map 으로). 일부는 지시된 대로 움직이고 몇 개는 "chaos monkey" 로 랜덤하게 클릭하면서 뭐가 깨지나 봐. 문제를 찾으면, 엔지니어 bot poteto 를 @ 해서 Cursor Project 를 하나 열고 high pri 이슈들을 다 triage 하고 고치게 해. 심각도에 따라서 수정을 release branch 에 cherry pick 해서 patch release 를 cut 하거나, 원래 있던 문제면 고치긴 하는데 다음 릴리스에 넣어 이것도 이제 Grok Bot 이 우리 팀의 귀찮은 작업을 또 하나 맡아줬어
Tibo
·
10월 6일 오후 04:12
♥ 223
Auto-review는 “Approve for me” 권한 모드예요. 사용하려면 컴포저 아래 권한 메뉴를 열고 “Approve for me”를 선택하세요.
Tibo
·
10월 6일 오전 07:22
♥ 916
full-access 대신 auto-review 써. 더 이상 트레이드오프도 아니고 더 편하게 잘 수 있어
Tibo
·
10월 6일 오전 07:13
♥ 1.2만
Day 2.1/ Auto-review를 ChatGPT 계정으로 로그인한 모든 사용자에게 무료로 풀었어요. 설정 > 권한 > auto-review에서 켤 수 있어요. Auto-review는 모든 걸 승인해야 하는 기본 샌드박스 설정을 개선한 거예요. 그 설정은 규칙을 오래 세팅하지 않으면 결정 피로가 쌓이기 쉽거든요. 긴 작업을 돌리는 동안 두 번째 agent가 메인 agent의 모든 동작을 리뷰해 줘요. 목표는 하나예요. 고위험 동작이 실행되는 걸 막고, 원래 사용자 의도에서 벗어난 원치 않는 동작으로부터 지키는 것. 이 Auto-review 기능은 이제 무료고, 플랜 사용량도 차감되지 않아요.
poteto
·
10월 6일 오전 03:30
♥ 1.7천
내일 Grok Bot 101 신청해! bot으로 진짜 일 해치우는 법 알려주는 좋은 라이브 워크숍이 잔뜩 있어
Tibo
·
10월 5일 오후 05:20
♥ 3.9천
30 TPS가 아니라 50 TPS에 도달하고 있어. 게다가 지금까지 중 가장 최적화된 토크나이저도 탑재. 모델들도 작업을 처리하는 데 필요한 토큰 수 면에서 꽤 효율적이야!
Tibo
·
10월 5일 오후 05:20
♥ 2.1만
Day 1/ GPT-6 Astra와 GPT-6.1 Sol의 기본 속도를 약 50% 빠르게 최적화했어요. Sign in With ChatGPT로 붙는 모든 제품과 파트너(OpenCode, Pi, Amp, Devin, ...)까지 포함해서요. 따로 할 건 없고, 두 시간 안에 체감될 거예요.
poteto
·
10월 5일 오후 05:17
♥ 2.6천
pstack 새 스킬: v0.15.13에 /poteto-help 추가! 진작 만들걸 그랬는데, 이제 pstack이 뭘 도와줄 수 있는지 궁금하면 /poteto-help한테 물어보면 돼! 내가 쓴 가이드 전부 먹여놨으니까 pstack 스킬이나 poteto-mode가 도움이 될지 애매할 때마다 그냥 물어봐!
Tibo
·
10월 4일 오후 12:30
37:23
OpenAI’s Head of ChatGPT: We’re entering a new era of AI (again) | Tibo Sottiaux
▶ YouTube · Lenny's Podcast
Tibo
·
10월 4일 오전 04:59
♥ 1.5만
좋아, 이제 정했다. 지금 하는 건 단순화, 더 많은 사용량을 위한 효율 개선, 획기적인 기능, 아니면 새 모델뿐이야. 때로는 앞서 투자해야 하지만, 피드백은 분명해. 다들 더 단순해지길 원한다는 거. 하고 있어.
Tibo
·
10월 4일 오전 04:35
♥ 664
한 일 - 보관할 필요 없는 이메일 카테고리를 전부 일괄 검토하고 삭제 - 내가 하는 업무 유형에 맞는 라벨을 파악하고 모든 이메일에 적절히 라벨 지정 - 답장이 필요한 이메일을 하나씩 안내해주면서, 제대로 답할 수 있도록 백그라운드에서 관련 맥락을 검색 이 과정에서 사람들이 직접 이메일로 보내온 피드백과 요청을 많이 처리할 수 있었다. 좋은 토요일이었다.
Tibo
·
10월 4일 오전 04:30
♥ 3천
평생 인박스 제로를 해본 적이 없었는데, 방금 dot한테 적극적인 목표로 맡겨서 도와달라고 했더니 드디어 해냈어. 얼마나 갈지는 모르겠지만 기분 진짜 좋다.
poteto
·
10월 4일 오전 12:32
♥ 82
참고로 dr eggbot으로 pstack을 전부 활용하는 고품질 엔지니어링 봇도 만들 수 있어!
poteto
·
10월 4일 오전 12:31
♥ 4.4천
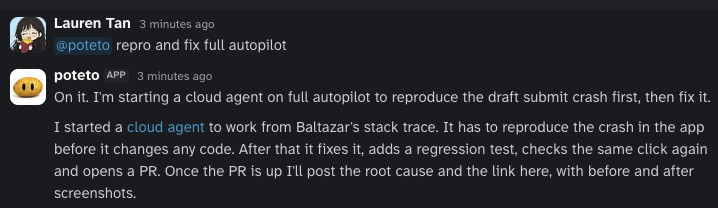
에이전트 행동을 만드는 환경을 고치는 대신 에이전트를 마이크로매니징하는 함정에 빠지기 쉬워. pstack 0.15.9에 새 /correct 스킬이 들어갔어: 같은 실수로 에이전트를 계속 고쳐주고 있다면, 패턴을 찾아서 아키텍처, 타입, 체크로 고쳐줘. 코드베이스로 빠르게 쏟아지는 commit을 제멋대로 쑥쑥 자라는 분재라고 상상하는 걸 좋아해. 해야 할 건 혼돈에 굴복하는 게 아니라 제대로 된 제약으로 의도적으로 길들이는 거야 0.15.9 개선 사항도 있어: • /architect: 이제 에이전트 친화적인 아키텍처 설계 방법이 포함됨 • @brendangregg의 벤치마킹 체크리스트를 바탕으로 한 새 /benchmark-checklist 스킬 pstack으로 더 나은 코드베이스 설계를 시작할 때 grok bot한테 줄 수 있는 프롬프트야: /poteto-mode 새 Project agent를 만들어서 우리 아키텍처가 에이전트 친화적이 되도록 내 repo를 리팩터링하고 재설계해줘. /correct랑 /architect 스킬을 둘 다 써서 과거 commit을 살펴보고, 코드 품질이든 성능이든 버그든 에이전트가 가장 자주 빠지는 함정을 찾아줘. 관련 있으면 /recall 스킬로 과거 대화를 찾아서 맥락으로 써도 돼. 내가 검토할 상위 수준 계획을 만들어줘. 열린 질문은 나한테 미루지 말고 프로토타입을 만들어서 스스로 답해. 실제 데이터로 뒷받침된 계획을 들고 돌아와. 내가 계획을 승인하면 stack이나 full autopilot playbook 중 하나(어느 걸 원하는지 물어봐)로 실행해
poteto
·
10월 3일 오전 05:08
1:05:36
LIVE: Poteto (creator of pstack) on shipping 1,000's of PR's a month at SpaceX
▶ YouTube · Matt Pocock
poteto
·
10월 1일 오전 08:35
♥ 79
야 @bot 다 되면 알려줘 나 잔다
poteto
·
10월 1일 오전 08:33
♥ 983
내 봇한테 내 머리를 줬더니 내가 뭘 원하는지 정확히 알아. 요즘은 이렇게 버그 고쳐.
2026년 9월
poteto
·
9월 27일 오후 01:00
45:04
We Built Grok Bot. Here Are Our 14 Best Bots | Peng Zheng & Lauren Tan
▶ YouTube · Peter Yang
Tibo
·
9월 9일 오후 03:56
1:14:22
Building Codex with Tibo Sottiaux
▶ YouTube · The Pragmatic Engineer
2026년 8월
Tibo
·
8월 24일 오후 06:11
44:28
How to Understand the Next Wave of AI Before Everyone Else | Tibo Interview
▶ YouTube · Matthew Berman
poteto
·
8월 13일 오후 10:00
28:41
Are Agents About to Replace Software Engineering? | Lauren Tan and Roshan Sadanani
▶ YouTube · MTS
2026년 6월
Tibo
·
6월 22일 오후 05:57
39:33
The New Shape of Engineering
▶ YouTube · Datadog
2026년 5월
Tibo
·
5월 22일 오후 03:30
31:08
Head of ChatGPT & Codex: agents for normal people are HERE
▶ YouTube · Silicon Valley Girl
Tibo
·
5월 14일 오후 08:28
43:03
Codex for Everyday Work: AI Agents Beyond Coding
▶ YouTube · OpenAI
전체 타임라인 보기 →