🥔
potibo
🔁
🎨
🌐
English
简体中文
繁體中文
日本語
한국어
Español
potibo
Dots style
Grok Bot style
首页
动态
时间线
梗指南
他们的动态
全部
🥔 土豆姐
🔁 提宝
▶ 视频
2026年11月
Tibo
·
11月10日 05:09
♥ 3154
Dots 现在除了我们默认提供的那台小云电脑之外,还能控制好多台机器了。
poteto
·
11月9日 19:32
♥ 3349
重置正在推送!
poteto
·
11月9日 17:16
♥ 1748
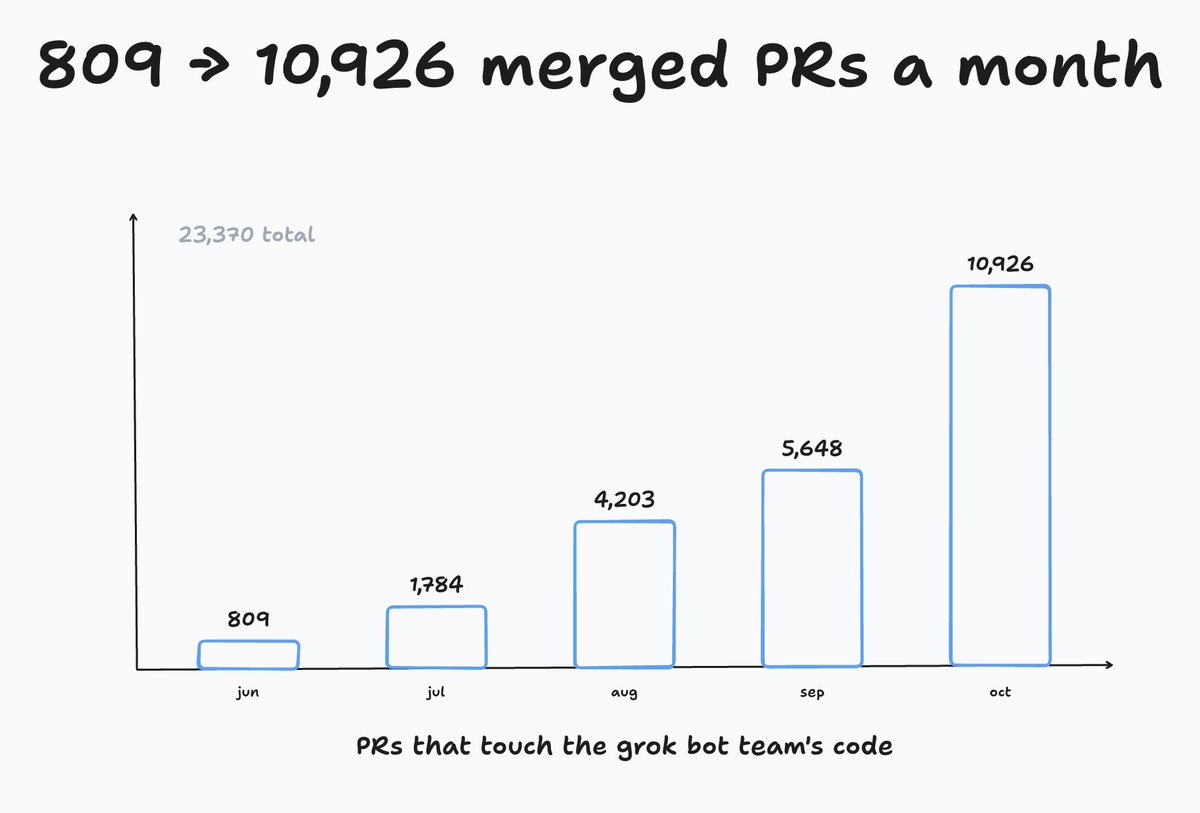
很期待这周三上午 10:10(PT)在 @aiDotEngineer 的分享! 我要讲的是 grok @bot 团队上个月怎么提交了 11,000 个 PR,同时没在代码质量上妥协。 希望在那里见到你!
poteto
·
11月9日 16:08
♥ 8713
我们正在进入编程语言和运行时研究的文艺复兴,还有软件测试与验证的黄金时代 是时候把所有软件重写一遍了
poteto
·
11月8日 20:02
♥ 4834
下次试试这个“用 /create-formal-verification-skill 来给这些状态机建模,每个子系统一个 skill。再用 /statechart 把我最重要的用户流程画出来” 两个 skill 都在 pstack 里
poteto
·
11月8日 06:18
♥ 1383
我让 grok bot 做了个视频,讲 tibo.dog 里的音乐是怎么做出来的!一开始我笨手笨脚地描述我想要的东西(我做音乐的经验是 0):有点 gameboy 风的音乐,在主旋律的各种变奏之间无缝切换,就像我玩过的另一个游戏(原神)那样 有个帮我把目标说清楚的 prompt,是跟 bot 说“我没有足够的词汇来描述我想要的东西”,再用 pstack 里的 /sharpen skill。然后 /in-your-own-words skill 帮我确认它到底有没有理解我想表达的意思 做这个视频的时候我也用了同一招,所以我的 agent 在做完整版之前先出了分镜和动态分镜 知道用对的词真的超有用
Tibo
·
11月8日 05:45
♥ 1.2万
出个 Pro 50 合理吗?你们觉得呢?
Tibo
·
11月8日 05:09
♥ 9383
看到有些人搞混了,其实所有 Pro 方案都没有 5 小时限制,和 Plus 相比的用量如下。 ✅ Pro 100 = 10X ✅ Pro 200 = 20X ✅ Pro 500 = 50X,还能用 ultrafast
Tibo
·
11月7日 06:27
♥ 1754
Cyber
Tibo
·
11月7日 05:30
♥ 1967
现在一个提示词能做到的事,真是挺酷的 👀
Tibo
·
11月7日 01:03
♥ 7710
今天是周五
Tibo
·
11月6日 20:29
♥ 170
后面还有更多,来参加我们 11 月 12 日上午 10 点(太平洋时间)的 Cyber at the Frontier 直播:
poteto
·
11月6日 07:54
♥ 8054
暴论:你不需要软件工厂,我也不太喜欢这个说法。那只是营销。 你需要的只是好的软件工程,把 token 投在对的地方。越是确定性的越好(也更省 token)。
Tibo
·
11月6日 05:01
♥ 2283
对数千万行代码做形式化证明已经不再是一件荒谬的事,而且在设计新系统时,这应该被纳入考虑范围。
Tibo
·
11月6日 05:00
♥ 1.5万
我可以很有把握地说,人类其实不太擅长写安全的基础设施。最终会走向人人都能用上的超安全基础设施和软件,但在那之前,我们得先经历一段动荡。
poteto
·
11月6日 02:23
♥ 92
Update 1 马上就来
Tibo
·
11月5日 22:26
♥ 643
如果我没算错的话,这每天超过5亿张图片。
Tibo
·
11月5日 22:24
♥ 3952
离谱的数据。我们现在在 ChatGPT 和 API 上每周生成超过 4B 张图片,而仅仅 8 周前还是每周超过 3B 张。
Tibo
·
11月5日 20:43
♥ 2220
来一起推进蓬松度的前沿吧
poteto
·
11月5日 18:52
♥ 2867
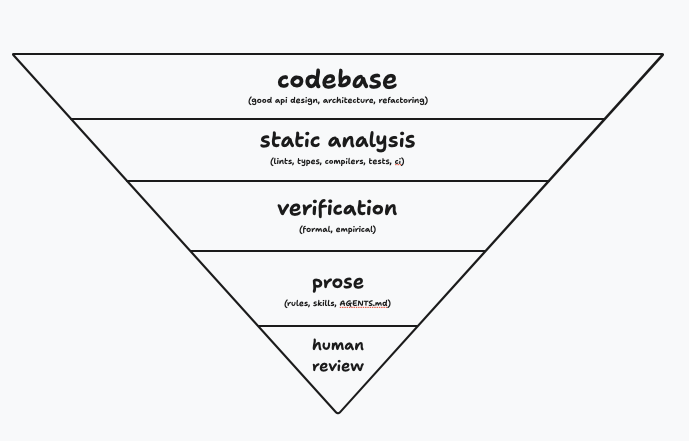
虽然我挺看好形式化方法的,但我觉得还是值得降低一下预期,自己去研究研究(免责声明:我不是这方面的专家)。它没法保证你的代码没有 bug,只能保证在某些假设下代码符合 spec,而 spec 来自人们想要什么,不是来自数学。只要我们还在为人类写软件,就没有什么能证明你的 spec 是对的,只有你自己能判断。 我在 pstack 里做 /statechart 这个 skill,主要是因为它能让你代码里隐含的状态机变得更明显、更好读,这样你就能缩小 review 的范围,在更高的层面去审:它到底符不符合你的意图和目标?我做游戏 tibo.dog 的时候狂用这个 skill,下面是故事模式的 statechart,我靠它找出了好多 bug。 从这个角度看,我觉得模型检测(比如 TLA+ 配 TLC)对端到端理解和检查系统的属性挺有用的,而且你不用写一大堆新的验证代码。spec 不是你真正的代码,所以总有漂移的风险,但到目前为止我用它找到真 bug 的体验都还不错。我一般也会配合经验验证(实际跑代码)来确认 bug 是真的。 其他类型的形式化验证,比如定理证明(如 Lean、Dafny)、有界模型检测(如 CBMC、Kani)等,各有各的取舍。证明能覆盖所有可能的输入,但只针对你写明的属性,而且要多写很多代码、多花很多功夫。有界模型检测可以直接跑在你真正的代码上,避免了漂移,但它只检查到一定步数,所以更擅长找 bug,而不是证明没有 bug。 所以我觉得在近中期,你还是得给代码库分层:约束和护栏(类型、lint 规则、API 设计、重构)、经验验证(测试、evals、真实使用),以及对真正需要的部分做形式化验证。单靠哪一个都抓不全,但叠在一起能抓到多得多的问题,也能缩小留给你 review 的部分。 不过也许到了极限,bitter lesson 会胜出,每次都能完美地打印出零 bug 的代码。就算是那样,/statechart 在确认 agent 有没有正确理解你的意图这件事上,看起来还是很有用。还没试过的话就去试试吧!
Tibo
·
11月5日 17:56
♥ 4195
我们最新的网络安全专用模型上线了。在很多网络安全相关的用例上,它是独一档的。通过 Daybreak Red 权限提供。
Tibo
·
11月5日 07:54
♥ 3565
想看 dot 的更新就关注 Samir
Tibo
·
11月5日 07:47
♥ 4025
能与这么多了不起的人并肩工作,是一种荣幸。他们不会停歇,直到我们共同实现更美好的未来。
Tibo
·
11月5日 01:02
♥ 3618
我们组建了一支世界级的网络安全团队,我很期待在未来几周和几个月里分享更多我们的工作。
Tibo
·
11月5日 00:29
♥ 6654
欢迎 Cat。超期待很快就能一起搞东西了。
poteto
·
11月4日 18:43
♥ 86
哦对了说清楚一下,这张PR图是grok bot所有的PR,不只是我的
poteto
·
11月4日 18:00
♥ 28
给你们做了只黑客猫
Tibo
·
11月4日 16:54
♥ 4140
电脑是有 RAM 的吧? 欢迎 Pierre。我们把一切重新发明一遍。
poteto
·
11月4日 16:26
♥ 2825
我要在 @aiDotEngineer 的演讲里放一些好玩的幻灯片 非常兴奋地分享我们怎么在不读代码的情况下发出海量代码(30倍),性能却跟刚上线时一样好甚至更好 当然还有很多要改进的地方,天花板也远远没到,但考虑到我们这种不停歇的发布速度和对打磨的高标准,我觉得我们在 agent 友好架构上的押注正在见效,把 slop 管住了 有趣的事实:10月大约有230人至少给 grok bot 提了1个 PR!
Tibo
·
11月4日 07:54
♥ 6163
ChatBLT
Tibo
·
11月3日 22:31
♥ 1.1万
事情会一次又一次又一次地变。我们还处在很早的阶段,今天的 agent 非常厉害,但还是让人很抓狂。等不及把问题啃下来,找回那种心流状态。前面的路还很长。
poteto
·
11月3日 22:27
♥ 1311
用 @bot 购物 用 @bot 省钱 用 @bot 上线 bot 让工作和生活都轻松太多了。回本好几倍都不止!
Tibo
·
11月3日 05:29
♥ 1.1万
Le GPT Fat
poteto
·
11月3日 02:04
♥ 1.1万
可能有点暴论,但我现在觉得对抗式审查基本就是浪费 token。不如把这些 token 花在实证验证加形式化验证上。我已经更新了 pstack,让它少用 interrogate skill,之后我可能会干脆把它删掉 我发现空泛的 code review 没啥价值,agent 往往就迷失在各种挑刺和 yagni 里了
Tibo
·
11月3日 00:26
♥ 3636
我们可是懂点 Git-fu 的。团队终于能稍微聊一聊这个了,很兴奋。@tnm 和团队太厉害了
poteto
·
11月2日 21:19
♥ 1335
hire grok bot!想给自己搭一个这样的数据 bot 的话,就 @bot,让它读这条帖子,带你一步步弄。
poteto
·
11月2日 18:51
♥ 2155
哇,tibo.dog 上线以来,非剧情模式已经玩了快 100k 局了!顺便说一句,正式玩法比剧情模式好玩多了 如果你喜欢这个游戏、想让我继续加内容,就在回复里告诉我你的点子和反馈吧 🤍 上线以来我加了 17 种新语言,做了些平衡调整,让它更好玩又有挑战,现在还在升级所有视觉特效。我对新的装备系统也有些想法! 我也会尽快找时间详细聊聊,我是怎么这么快做出这个游戏、还打磨得这么细的
Tibo
·
11月2日 15:51
♥ 2455
你的 dot 会为任务选择最合适的模型,在工作的不同部分调用不同的模型。
Tibo
·
11月2日 15:50
♥ 1.1万
各位 resetters,提前说一声:我们正在扩充给 dots 提供支持的 frontier 模型家族,包括 GPT-6 Astra 和 GPT-6.1 Terra,未来还会有一些别的。Terra 带来了速度和一些不错的性格升级,也会帮我们把 dots 带给更多人。
poteto
·
11月2日 00:00
♥ 349
cc @DavidKPiano 我觉得你会喜欢这些图表
2026年10月
poteto
·
10月31日 17:18
♥ 624
更多小技巧: • routines 能让你的 bot 更主动。你可以设一个定时的,比如“每天早上查一下我们的 issue tracker 有没有新 bug”,也可以设一个订阅式 routine,在某件事发生时做出响应,比如“每次收到客户 X 的邮件,就自动总结一下,把他们的反馈和建议加到我的 notion 文档里” • routines 触发太频繁的话会很费钱。定时的我最多建议每小时一次,订阅式的话应该先把事件过滤一下 • 让你的 bot 帮你写代码来自动化任务!代码效率高多了,比 bot 自己亲自去做要省很多 token。直接问你的 bot,你的工作流里哪些部分可以改成脚本和 skills。然后让它把脚本存到一个私有的 github repo 里 • 如果你用的是团队版,就在 slack 里分享你的 bot!这是跟同事分享工作流的好办法,也能复用团队里已经在维护的高质量 bot • 像经理一样思考:怎么让 bot 帮你干活,质量跟你自己做一样甚至更好?如果你能把 bot 配置成这样,你就能腾出手去做更有野心的事
poteto
·
10月31日 17:01
♥ 1.1万
这里是一份简短的 grok bot 指南,讲我怎么做出高质量的 bot,以及怎么管理我的团队。让 @bot 读一下这篇帖子,帮你的团队也升个级! • 把 dr eggbot 加进你的团队!他是我用来做 bot 的 bot 设计师 • 你不需要很多 bot。几个好的 bot 可能比一大群更有用、也更好管 • 在你教 bot 怎么做任务的时候,让它给自己创建 skill。这样即使对话很长,它也能更稳定地完成。你甚至可以让它给你建一个私有 github repo,把所有 skill 存进去,单独保存 • 加上 connector、用上 vault,把你工作用的所有工具都开放给它。你也可以让 bot 自己开一个邮箱,它就能自己注册账号,隔离得更干净 • 想想你手动做的所有工作,或者工作流里那些要把信息复制粘贴回 bot 的步骤。直接问你的 bot,它能怎么替你做了! • 想象你招了一个实习生,你会怎么带他上手、怎么让他把活干得又快又对?先向你的 bot 自我介绍,说说你在做什么,然后问它能怎么帮你自动化 还有我最喜欢的一条:用语音模式或者转写功能!这是把一大堆信息一口气倒出来的好办法。然后在最后跟你的 bot 说一句“用你自己的话说一遍”,确认它真的听懂了
Tibo
·
10月31日 05:42
♥ 1.4万
Day 26/ 现在在手机上可以轻松切换多个账号了,桌面端也快了。接下来两天会有重置……备着呢……你们自己看着办吧 👀
poteto
·
10月30日 22:52
♥ 2465
快给我看看你们用 /statechart 做出来的各种酷炫图表!还有用 /create-formal-verification 技能抓到的 bug pstack 在这儿就能装
poteto
·
10月30日 15:34
♥ 6008
我们得重建、重写大量软件,去适应一种全新的、更快的节奏。 以前代码是一滴一滴来的。很快(如果现在还没有的话),代码会像一股连续不断的水流一样被写出来,像一条狂暴的河,想怎么拐就怎么拐。 这不是什么新鲜事:大厂早就因为工程团队规模巨大而不得不面对这个问题。但现在 ai 给每个工程师都配上了一支弹性极强、能力超强的劳动力。这现在是你的问题了,唯一的适应办法就是进化你的系统,让 agent——即使是、尤其是那些不太了解正确做法的 agent——也能如鱼得水。让简单的做法就是正确的做法。 你的代码库正在变成有机建筑。agent 的贡献会围绕你设计的约束和护栏生长。好的软件工程现在更重要了!而且不,这股连续不断的代码流不是你只能无助旁观的东西。野心大一点,去设计能驾驭混乱的系统、框架和语言。 为写代码哀悼的时候早就过去了
Tibo
·
10月29日 19:35
♥ 4761
把你们善意的反馈发给这个人。
poteto
·
10月29日 18:55
♥ 7227
pstack v0.15.36 里的 /statechart 技能现在稳定可用啦!最好搭配 /create-formal-verification-skill 一起用,对状态机和分布式系统做抽象建模来找 bug。 这个技能里有个迷你 tlc 编译器,会解析、降级成一个小 IR,后端输出 mmd 语法。你想的话也可以让你的 agent 按你喜欢的任何风格画图,这个技能会让它用 pele.run,主题可以随便改,所以你可以做蓝图、手绘百科插画风或者任何你喜欢的样式 这是 /statechart 技能的图,还有我刚找到的 2 个真实 bug。来试试,告诉我你觉得怎么样!
Tibo
·
10月29日 16:56
♥ 3.9万
Day 25/ 即日起,我们将所有 Pro 100/200/500 档位及 Business Premium 的使用量上限全部翻倍。 我们听到了大家的反馈,不会削减 Pro 200 的使用量上限,所以你的 Work 和 Codex 用量保持不变。我们也会继续为 dots 提供扩展上限,dot 的使用量仍将与默认用量分开计算。 当然,我们也会持续推出更好的模型以及其他效率改进,让你的实际可用量随时间不断提升。
poteto
·
10月29日 03:34
♥ 652
用 grok bot 来购物吧!
Tibo
·
10月29日 01:49
♥ 3969
Day 24/ 给你的 dot 发短信,就跟联系任何人一样。转发、分享内容超方便,还可以留语音消息。你甚至可以玩点花样——"Hey Siri,给 Iggy 发条消息:<INSERT WILD REQUEST>"——然后坐等结果。
Tibo
·
10月28日 23:35
♥ 6024
团队正在做这个,但还没正式推出,抱歉造成困惑。计划是今年某个时候把 Chat / Work 两边最好的能力整合到一起,不过我们会谨慎推进,慢慢来。 很快会有更多消息分享。
poteto
·
10月28日 23:28
♥ 3250
grok bot 让我发这个
poteto
·
10月28日 00:41
♥ 1071
shipping 越来越猛了
poteto
·
10月27日 17:26
♥ 2150
Grok Bot 团队以惊人的速度交付高质量成果!我们一直在投入让代码对 agent 友好,让简单的事就是正确的事。工程师、设计师和 PM 每天贡献数百个 PR:修 bug、打磨用户体验、让 app 更快更稳定。当然也不完美,我们也会犯错,但目标是每次都学到东西、改进流程,让我们的 bot 不犯同样的错误。 我个人认为 Grok Bot 是目前行业内所有 token 花在什么地方的最好例子:质量和速度,不妥协。在关于 token 用量的讨论中我觉得大家忘了软件开发是座冰山——新功能只是维护高质量软件工作的一小部分。 而且我们会继续加速和改进!
poteto
·
10月26日 20:38
♥ 892
快雇 Grok Bot!
Tibo
·
10月26日 19:24
♥ 1万
第22天/ Terra 回来了! 这是我们第一个在写作、个性和对请求的细腻理解上明显更强的模型。 全方位都很能打,电脑操作非常强,而且在 API 和订阅上的用量都是 6.1 Sol 的 2X。
poteto
·
10月26日 17:34
♥ 1322
这周你们打算用 Grok Bot 发布什么?
poteto
·
10月26日 07:54
♥ 2689
这场关于怎么为 agent 改进代码库的演讲里,干货和金句太多了 • agent 靠反馈成长,而类型是最好的反馈之一 • 用类型让非法状态无法表示,这样就能在整个代码库里强制执行全局规则 • 属性测试、fuzzing,甚至全系统确定性模拟测试 • expect 测试:直接把东西打印出来,在测试里捕获。让行为变得可读。这跟编译器的 fixture 测试很像,能缩小需要 review 的范围 • 形式化方法过去非常昂贵:seL4 大约有 8,700 行 C 代码,花了约 25 人年,每行 C 代码对应 23 行证明,但 agent 改变了 ROI
poteto
·
10月26日 06:43
♥ 2648
真的很期待未来几年编程语言会冒出的各种创新
Tibo
·
10月26日 05:48
♥ 4143
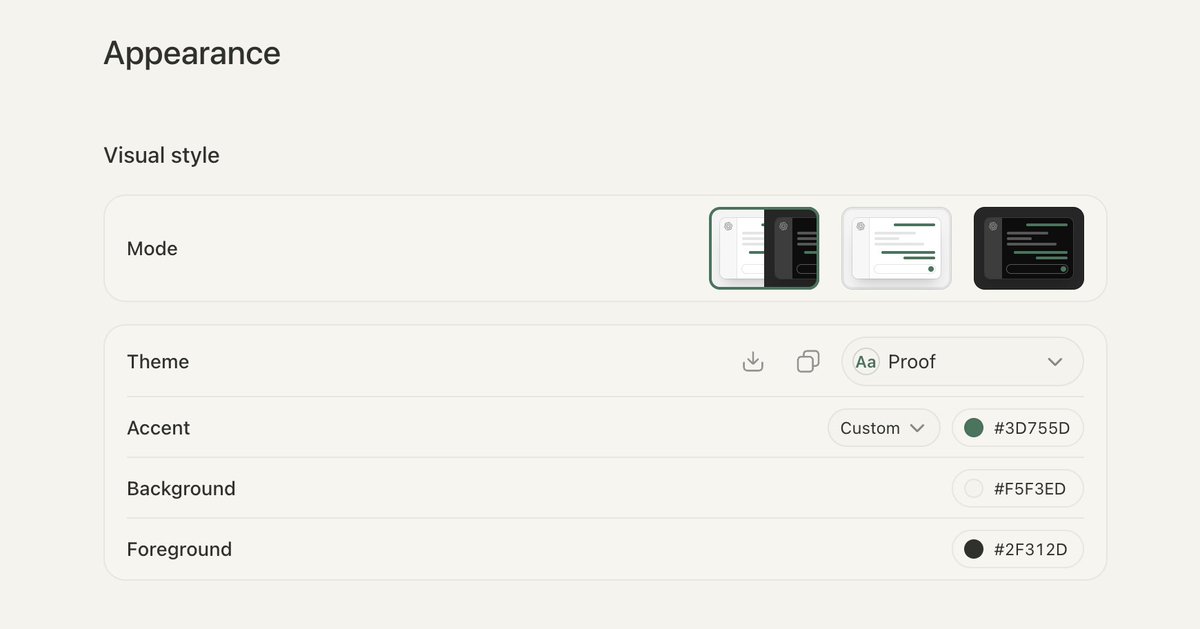
提醒一下,网页版 chatgpt 的外观是可以自定义的,可以把它调得很治愈
poteto
·
10月26日 05:05
♥ 5985
还好我之前就把这个有毒的家伙拉黑了,当时他就在对别人居高临下。另外 meta 有自己的 scm,我的 commit 又不是全公开的 🤡
poteto
·
10月26日 02:21
♥ 1342
唯一剩下的护城河就是 sybau 💔
poteto
·
10月26日 02:00
♥ 1927
很少有人知道这个
poteto
·
10月26日 01:53
♥ 2650
好像打破了我的记录
Tibo
·
10月25日 06:06
♥ 5738
全部生效了。明天尽情疯狂用 Codex 吧。这周还有好玩的。
Tibo
·
10月25日 03:39
♥ 1.2万
第20天/ 休息和重置
poteto
·
10月24日 20:42
♥ 2154
这个我在我的 pstack 指南里写过!
Tibo
·
10月24日 19:21
♥ 8603
如果你想帮忙把 dots 扩展到 1B 用户,而且以前做过类似的事,私信我
poteto
·
10月24日 19:07
♥ 1480
我最喜欢的事情之一就是让我们的机器人们互相协作!只要把你的机器人加入 Slack,就像队友一样一起工作 🤍
Tibo
·
10月24日 16:26
♥ 5877
周六就是用来边喝咖啡边修 bug 的。旧金山有什么好地方可以去待着?
Tibo
·
10月23日 23:13
♥ 1811
说说 codex cli 的更新。我们加了可复用的提示词预设、内联的模型和权限设置,还有企业版 MCP 登录。我们也修复了恢复长会话时失败的问题,并加入了 Windows 企业代理认证。 没想到自 devday 以来,CLI 的使用量涨了 2X。
Tibo
·
10月23日 23:12
♥ 8303
Day 19/ 一些小更新。dots 的通话接通快多了,在 codex 和 work 里对话中途切换推理档位也不会再让缓存失效了,另外我们还更新了 codex cli。
poteto
·
10月23日 20:04
♥ 1708
用 Grok Bot 的时候注意安全!
Tibo
·
10月23日 04:47
♥ 3148
明天太平洋时间早上10点前落地,还跟一个小版本一起。
poteto
·
10月23日 00:24
♥ 1880
grok bot 团队的上新速度简直离谱!请继续给我们发反馈和 bug 报告,我们会继续努力改进和打磨 grok bot,让它成为你能雇到的最好的助手和员工
Tibo
·
10月22日 06:55
♥ 3296
明天太平洋时间上午 10 点前到。
poteto
·
10月20日 01:33
♥ 3144
什么都能上线。
poteto
·
10月19日 19:29
♥ 156
盯着这串帖子,根据你对我和我工作的了解,给我提点改进我的 bot 和工作流的点子
poteto
·
10月19日 18:15
♥ 2462
你们上周用 grok @bot 搞定了啥?
Tibo
·
10月17日 16:21
♥ 2804
今天太平洋时间结束前某个时候上线。
Tibo
·
10月17日 00:15
♥ 915
另外我们昨天刚加了幻灯片支持,快去试试。目前先在 Pro、Business 和 Enterprise 开放,同时听听大家的反馈。
Tibo
·
10月17日 00:14
♥ 2749
ChatGPT Space 是什么,这就是问题所在。有时候会尴尬得挺可爱,因为做它的就是真正的团队。你们接下来想看什么?
Tibo
·
10月16日 23:57
♥ 872
还有,去更新你的 app,享受这个宝贝吧
Tibo
·
10月16日 23:56
♥ 1705
我们还给所有 pro 用户大幅提升了 GPT-6 Pro
Tibo
·
10月16日 23:55
♥ 1.1万
Day 12/ 我们对 Codex & Work 做了一些改进,让你能获得更多有效用量。我们通过在子代理间复用上下文、延长上下文缓存时间,以及优化请求路由来提高缓存命中率,实现了这一目标。
poteto
·
10月16日 03:21
♥ 4809
终于可以不用害怕侧方停车了
Tibo
·
10月15日 22:45
♥ 4152
你好
poteto
·
10月15日 15:44
♥ 91
注释是没有结构、也没法强制执行的文本。agent 确实会读注释,但它们经常被无视、会过时,还会给你的 agent 留一个后门,让它去打补丁、搞 hack 或者绕路,而不是好好解决。 用这个提示词审查一下你的代码注释,找找能通过更强的类型、更好的 API 设计来改进代码的地方,再加上 lint 规则,这样就不需要那些注释了!
poteto
·
10月15日 15:42
♥ 160
这里有一些超好用的 pstack 提示词,可以拿来升级你的代码,先从这条开始(提示词在帖子最下面) 重构代码,让它对 agent 更友好
poteto
·
10月15日 15:37
♥ 4922
来试试 pstack!这是我自己的一套技能包,用来跟 agent 一起做严谨、自主的工程开发。我会一直调优、精简,所以更新很频繁 10 秒教程: 1. 运行 /setup-pstack,选好你的预算 2. 在任何想要严谨完成的 prompt 前面加上 /poteto-mode 3. 不确定该用哪个 pstack 技能时,就问 /poteto-help 4. 就这样!
poteto
·
10月14日 02:14
♥ 2760
用不了多久"让你的 bot 跟我的 bot 聊"就会变得很常见! 多人 Grok Bot 通过邮件的一些有趣用法可以是: • 调试(你可以把 bug 报告发给我的 bot!) • 客服 • 预订会议和活动 • 拼团 • 在 craigslist 上买卖东西 你们都用 bot 邮件做过什么?
poteto
·
10月13日 16:39
♥ 134
如果你是通过 grok bot 或 cursor 安装的 pstack,它会自动更新!
poteto
·
10月13日 16:37
♥ 2344
pstack 0.15.23 现已支持新技能 /in-your-own-words!超级实用,能确保你和你的 agent 在目标上对齐,让它清楚理解你的意图。
poteto
·
10月12日 17:39
♥ 308
另外,请大家去看我的演讲。
poteto
·
10月12日 17:37
♥ 4622
一直让我挺在意的一点是,有些人把 slop 当成是发生在自己身上的事,好像自己只是个无能为力的旁观者,什么都做不了 不好意思,你可是软件工程师啊,你 literally 学会了怎么让沙子思考、让电脑听你指挥?!现在你却说你对这事没办法?拜托 想穿过这些噪音,你其实只需要知道两件事: 1. 你得给你的 agent 一个能验证自己工作的方式(我刚发过,就不重复了) 2. 你的代码库就是记忆 第 2 点也不是什么新鲜事,我们一直都有 lint 规则、诊断做得好的编译器和强类型系统、LSP 等等,帮我们写出更好的代码。写代码的人换成 agent 也没什么不同,你只是需要更多、更强的这些。 先别管 rules 和 skills,这些以后再加。 是的,你的代码库对 agent 来说就是一种记忆!agent 特别喜欢在已经存在的东西上继续扩展。所以你见过的每一个小毛病、每一个烦人的点,你从 agent 身上看到的每一个错误和坏模式,都得变成一条约束,否则 agent 就会像病毒一样在你的代码里不断重复同样的错误。然后你不断观察、不断重复这个过程,直到你的代码库被锁得足够紧,哪怕是上下文很少的 agent 也能一发打出一个高质量的 PR。 更好的方向是重构/重写你的代码,让 agent 的反模式在类别上就不可能发生。把类型系统用起来,用那些能缩小架构搜索空间的库/框架,或者干脆像我们给 grok bot 做的那样,自己造一个框架,设计高质量的底层原语和想清楚的 API
poteto
·
10月12日 04:54
♥ 142
还发现了几个小 bug,正在修,不过 0.70.2 里那个修复才是你们桌面客户端会休眠的最大原因
poteto
·
10月12日 00:16
♥ 1882
这个已经修好了,0.70.2 已发布!正在推送中
Tibo
·
10月11日 23:48
♥ 3590
有了这次改动,用订阅额度时,我们不再对 GPT-6.1 Sol 收取长上下文费用。
Tibo
·
10月11日 23:45
♥ 1.5万
Day 7/ 通过 Codex & Work 使用 GPT-6.1 Sol 时,默认上下文长度我们已经提到 500k,之前是 272k,提升了大约 80%。 以后还会再往上加,不过这次已经能减少压缩(compaction)的次数,也更适合那些需要长时间记住大量上下文和细节的任务。我们仔细测试过,这是目前对大多数用户来说的最佳平衡点。想调高或调低也还是可以自己改,GPT-6.1 Sol 的最大上下文长度是 1M。
poteto
·
10月11日 18:54
♥ 4375
挺有意思的,好多人回复我说可维护性和整洁代码依然很重要。我倒觉得这已经不成立了,大家都该更新一下先验,重新想想 2026 年的“好代码”到底意味着什么。 整洁代码一直都是有代价的——性能。各种间接层、让代码对人类可读可理解,这些都不是免费的,往往要以更差的性能为代价。我们过去能接受这一点,是因为有摩尔定律,而且大部分代码都不在热路径上。 这些原则也来自人类维护代码的年代。那时候为人类优化是合理的,但现在代理已经在写所有代码了,这就没那么合理了。我们其实很可能会发现、提出新的原则:对代理友好的架构原则(我打算很快多写点这方面的想法)
poteto
·
10月11日 17:27
♥ 92
poteto
·
10月11日 04:42
♥ 114
还有一篇很有意思的文章,自从 @tomocchino 发给我之后,我就一直会回去重看
poteto
·
10月11日 03:26
♥ 680
tldr 所有代码都是垃圾
poteto
·
10月11日 02:35
♥ 5588
代码库里一直都有糊弄出来的东西。我们一直都能接受,因为除了任务关键的“硬”软件(比如嵌入式),代码很少需要完美。 swe 是一种很独特的工程,因为你经常在造一个不断演化、几乎有生命的东西——用户口味会变,你的心智模型会变,功能来了又走。 说实话,我和很多写了很久代码的人一开始(比如 2024 年那会儿)都怀疑 agent 会不会写生产代码。“那我们漂亮的代码库里混进来的那些垃圾怎么办?” 可是以前就有人类写的垃圾,而且多得是!说真的,大多数人把“不是我写的代码”叫垃圾。现实是 99% 的人(包括我自己)根本不知道好代码长什么样,更别说写得出来。我斗胆说,好代码是: • 正确 • 没有 bug • 跑起来又快又省钱 真正的好代码一直都是又难又贵,因为很长一段时间里(也许 @bendlang 会改变这一点),代码并不是能便宜、形式化地保证同时具备这三点。这就是为什么写硬核软件更难更贵,因为看场景,你可能只有一次机会,所以一开始就得对。 但我们用的大多数软件并不需要是好代码才有价值。事实上,我们用的软件很可能大多都没法形式化验证!我们用一些 bug 换速度和进步,所以靠测试和 o11y,采取更迭代的方式。这是好事! agent 帮我们跑得更快,如果你愿意接受,它也能帮我们写出更好的代码。它不会是“好代码”(那还是很贵),但平均下来、规模化之后很可能是好得多。 swe 的新手艺就是搞明白怎么做这件事。现在这是你的活了!如果你用不用 agent 的生产力没差多少,那你是哪里做错了。但现在接受它、把它当成学一整棵新技能树的机会,还不算晚。
poteto
·
10月10日 20:52
♥ 4321
我同时开着的 cursor Project 太多了(现在有 16 个),以至于我最常用的提示词已经变成 「/bro 把我上条消息之后发生的所有事都给我补一下,如果有需要我处理的事项,给我足够的背景(执行摘要),让我能做决定」
poteto
·
10月10日 16:20
♥ 1099
嘿 @bot,把这条引用串整条读完,想想你能怎么帮我的工作和生活出出主意
poteto
·
10月9日 23:15
♥ 3820
顺便说一句,最近关于软件工程技能的讨论挺多的(比如 ruby/rust/elixir 那场争论)。我有点纠结,一方面我确实觉得软件工程的原则和模式还是很重要,但同时我也在想,会不会有一天它们就不再重要了。不是说它们没用了,而是当你用 agent 的时候,你自己的直觉就能把空缺补上,靠的是一种直觉上的感觉,而不是明确知道它们在干嘛 如果这听起来不太好懂,我想到的类比是第一代 iphone。20 年前你得是专业人士、有昂贵的设备才行,现在只要一部手机加上一点创意,就能拍出能打动新受众的内容。我不知道这有没有专门的说法,但我想叫它“技能压缩”。就是以前被门槛挡住、只有专家才玩得起的东西,变得对一群新的创作者开放,还带来了全新的玩法。细节慢慢淡去了,现在的手艺不在于懂设备、会用设备,而在于你怎么有创意地去用它 我们会看到一整代从没见过、也没写过一行代码的新 builder 做出超厉害的东西
poteto
·
10月9日 22:42
♥ 6449
我感觉软件工程师面试大概可以压缩成只有 2 轮技术面: • 系统设计(你能把自己的想法讲得多清楚,你是不是真的懂怎么把东西工程化) • 现场项目,用智能体做一个真东西(你能不能把你的意图转化成高质量的成果) 以前问的其他那些,都已经没必要了
poteto
·
10月9日 17:41
♥ 63
如果你无法标记 @bot,请用你的 Grok Bot 邮箱登录 https://grok.com,然后绑定你的 X 账号
poteto
·
10月9日 17:40
♥ 720
问问你的 bot,或者在 X 上 @bot,让它帮你搞定设置!
poteto
·
10月9日 16:18
♥ 423
如果你是编程新手,下载我的 bot 然后问它: “帮我做一个工程师 bot,用 cloud agents 和 pstack 来干编程的活。它要建一个 project,把相关的任务归到一起”
poteto
·
10月9日 15:50
♥ 939
来用 Grok Bot 写写代码吧!
poteto
·
10月8日 20:29
♥ 124
这是我所有 PR 的来源(截至今天)
poteto
·
10月8日 20:17
♥ 4050
量确实重要 听着,我懂。如果你在 agent 出现之前就是工程师,那你对拿代码行数和 PR 数量来衡量任何形式的生产力持怀疑态度,完全合理。我也同意!或者说,至少我以前同意。为了方便解释,我会从一个至少 50 人的大团队里的工程师视角来讲。 以前量不重要,因为我们看的是影响力。就算 PR 不多,你也可以有很大的影响:比如改一行配置,就可能给公司省下几百万美元。 但在 agent 出现之前,我看到量被拿出来讨论的时候,基本都是针对极端情况。差的一端可能是表现吃力的人,另一端可能是“编码机器”型的人。所谓编码机器,就是那种能把自己关在房间里,出来时抱着一摞 PR、解决了一大堆问题的人。所以量确实重要,但只在分布的两端,而且要和影响力结合起来看。 如果你在大厂干过,你就懂我的意思。agent 的特点是,大厂的问题现在也成了中小公司的问题。 agent 怎么改变了这笔账?嗯,现在每个人都有能力成为编码机器。你手里有极其强大的前沿模型,写代码比我们任何人都好,速度也比我们快得多。在这样的世界里,如果你产出的 PR 数量还和以前一样,你难道不会停下来想想,为什么自己没有变得更高效?外星智能都来了,你却还比不过一个人类编码机器? 这又回到我为什么一直在讲信任。如果你没下功夫去建立对 agent 输出的信任,就很难把生产力规模化。 没错,这种做法确实需要更多 token,但我是从“每单位智能的成本”来考虑的。在 agent 之前,这个成本非常高——你得雇很多拿六位数高位年薪的软件工程师来干活。token 现在还是贵,但算上智能的成本,它很可能会随着时间变便宜。今天看起来离谱的开销,6 个月到一年后很可能就负担得起了。一个用 agent 的工程师,能干几十甚至上百个工程师的活,成本只是零头。 我觉得大家还没真正意识到的现实是:软件工程师的工作真的变了。我们的工作不再只是生产软件(好吧说实话从来都不只是写代码,但为了解释先忍我一下),而是打造那台写软件的机器。这种软件工厂的想法,或者我喜欢叫它米其林厨房,现在还是个研究课题。这也是我喜欢分享的东西,不是为了炫耀,而是想让你们看看,当你在大规模使用 agent 时投入大量严谨性,能做到什么。
poteto
·
10月8日 16:28
♥ 102
想@到 @bot 的话,记得用你的 Grok Bot 邮箱登录 grok.com,然后绑定你的 X 账号!
poteto
·
10月8日 16:25
♥ 1839
嗨 @bot,帮我留意 X 上大家用 Grok Bot 做的有趣东西,每天早上 9 点在 Slack 上给我发一份摘要。如果有相关的内容,挑出最酷的点子,并建议我怎么用它来改进我的工作流。
poteto
·
10月7日 22:37
♥ 119
另外这个所有用户都能用,不需要设置 X 连接器
poteto
·
10月7日 22:37
♥ 1654
让你的 Grok @Bot 帮你在 X 上盯着用户对你产品的反馈!功能需求丢进你的 issue tracker,bug 报告交给 cursor cloud agent 或项目去分诊和修复 闭环完成
Tibo
·
10月7日 21:03
35:01
OpenAI’s Tibo Sottiaux doesn’t want humans to be an ‘afterthought’
▶ YouTube · Pioneers of AI
Tibo
·
10月7日 19:19
♥ 2万
Day 3/ 今天的重头戏是 GPT-6 上线 Chat,不过今天也是个小小的庆祝日:Codex 和 ChatGPT Work 的活跃用户创下 40M 新高。 正在给所有人的付费账户发放一次存着的重置。明天见!
poteto
·
10月6日 22:33
♥ 82
,我们也支持 @Atlassian。
poteto
·
10月6日 22:19
♥ 1598
我经常聊 Grok Bot 在 Slack 上的用法,不过你知道吗,你也可以把它加到 @MicrosoftTeams 里?
Tibo
·
10月6日 20:56
♥ 5128
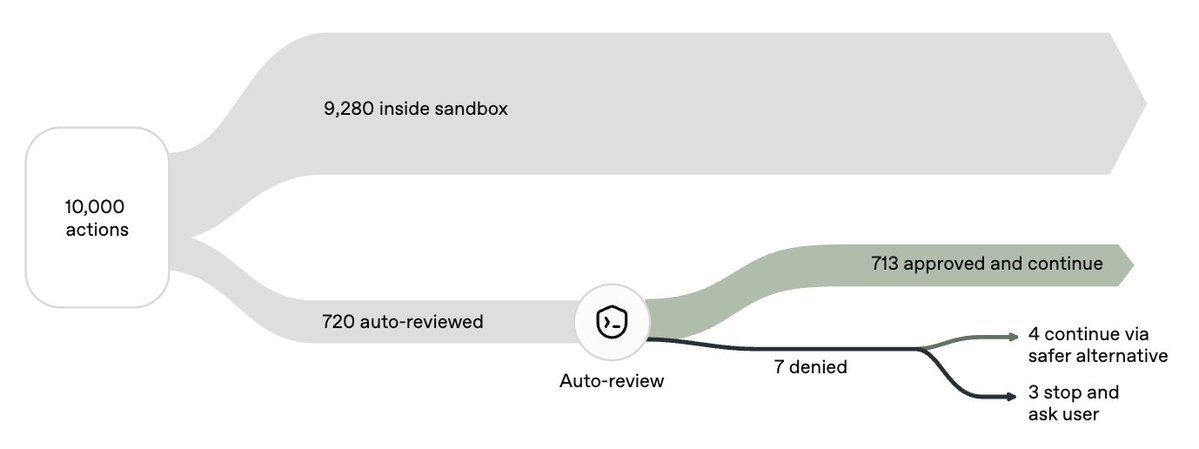
Day 2 小结/ 2.1/ “Approve for me”(自动审查)现在已经包含在内,而且不占用用量。使用时大约会占套餐的 2-10%。对你也更好。 2.2/ 给开发者更简单的 API。 2.3/ 会议纪要已整合。 2.4/ 决策 API 已对开发者上线。会在应用里用上,改善体验。
Tibo
·
10月6日 19:09
♥ 2769
Day 2.2/ 好吧,这个改动小一点,但我们把在 API 上构建时的一些摩擦去掉了。祝你构建愉快。
poteto
·
10月6日 17:51
♥ 217
这一切能实现,都是因为我们有一个高质量的验证技能!用 pstack 自己做一个吧
poteto
·
10月6日 17:43
♥ 2900
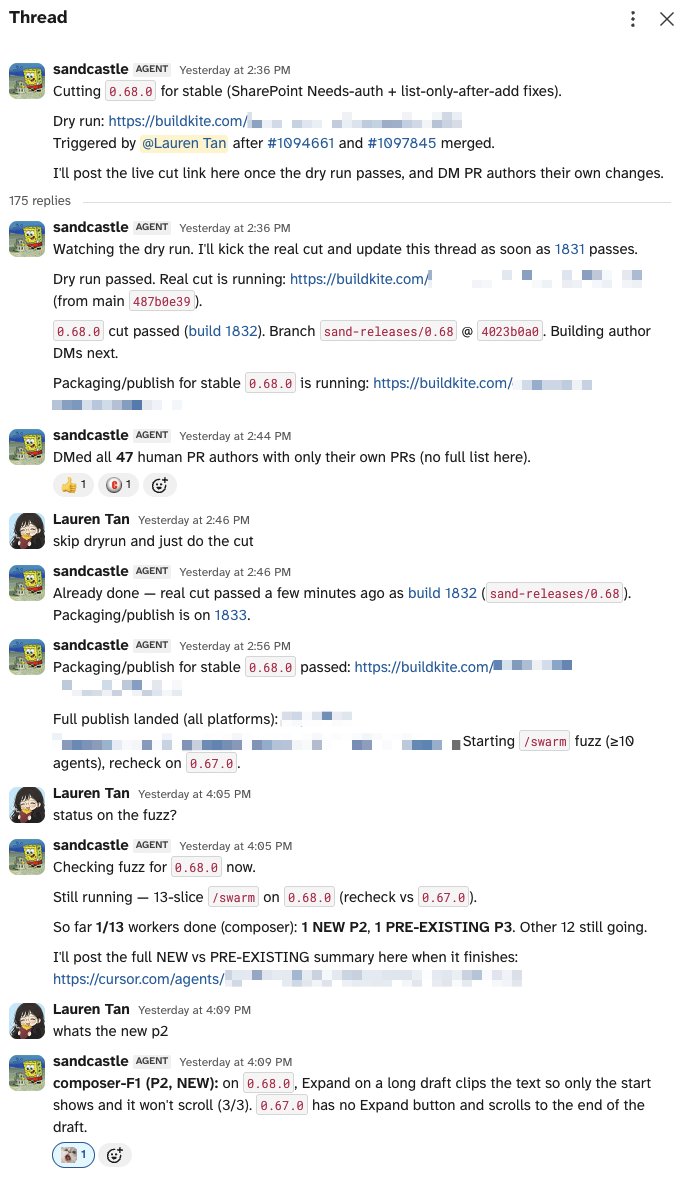
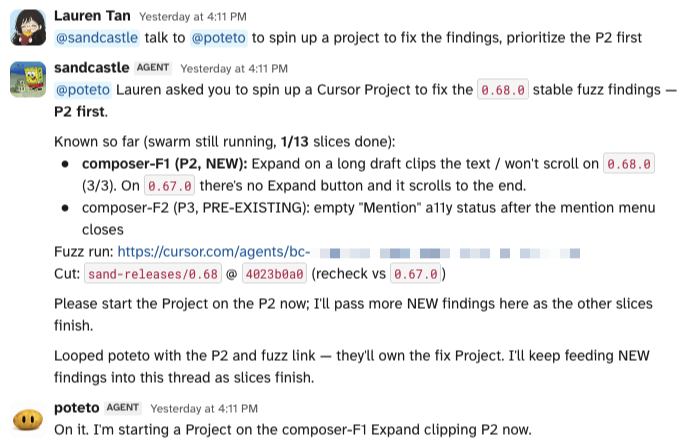
我刚把我们发版和 QA 流程自动化了!用 Grok Bot 我做了两个 Team Bot:sandcastle,我的发版经理,和 poteto,我的工程师 bot。我把它们加到 Slack 里,建了个新 channel 来管理发版。 先告诉 sandcastle 我要做一次 cut。它会 DM 所有 contributors,附上他们 PR 的链接,让他们知道下个版本有哪些内容,有问题或反对可以直接 DM 回这个 bot。 然后 sandcastle 启动 build,自动盯着它,并启动一个自动化 fuzz swarm。一般是 10+ 个 agent 跑在 Grok 4.7 xhigh 上来运行 build、点来点去像真实用户一样使用它(用我们的 verification skills 和 feature map),其中一些是有引导的,另外几个是 "chaos monkey" 随机乱点看看什么会坏。 发现问题时,我会让它 @ 我的工程师 bot poteto,开一个 Cursor Project 来负责 triage 和修所有 high pri 的问题。看严重程度,我可能会让它 cherry pick 修复到我们的 release branch 然后发一个 patch release,或者如果是已有的问题我也修但放到下个版本里 这又多了一个 Grok Bot 帮我们团队搞定的繁琐任务
Tibo
·
10月6日 16:12
♥ 223
Auto-review 就是“Approve for me”权限模式。要使用它,打开输入框下方的权限菜单,选择“Approve for me”。
Tibo
·
10月6日 07:22
♥ 916
用 auto-review 代替 full-access 吧。已经不是妥协了,而且你能睡得更踏实
Tibo
·
10月6日 07:13
♥ 1.2万
Day 2.1/ 我们把 Auto-review 对所有用 ChatGPT 账号登录的用户免费开放了。你可以在 设置 > 权限 > auto-review 里开启。Auto-review 改进了默认的沙箱设置——那个设置要求你批准每一步,除非你花很多时间去配置具体规则,否则很容易让人决策疲劳。 它让你可以跑长任务,同时由第二个 agent 审查主 agent 做的所有操作。它唯一的目标是阻止高风险操作被执行,并防止出现不符合用户原本意图的、不想要的操作。这个 Auto-review 功能现在免费,而且不占用你套餐的用量。
poteto
·
10月6日 03:30
♥ 1725
快来报名明天的 Grok Bot 101!有好多超棒的直播工作坊,教你怎么用 bot 把正事搞定
Tibo
·
10月5日 17:20
♥ 3894
速度已经达到 50 TPS,不是原来的 30 TPS,还配上了目前最优化的分词器。模型在完成任务所需的 token 数上也相当高效!
Tibo
·
10月5日 17:20
♥ 2.1万
Day 1/ 我们已经把 GPT-6 Astra 和 GPT-6.1 Sol 的默认速度优化到大约快 50%,覆盖我们所有产品,以及通过 Sign in With ChatGPT 接入的合作伙伴(包括 OpenCode、Pi、Amp、Devin……)。 你那边不用做任何改动,接下来两个小时内应该就能感受到。
poteto
·
10月5日 17:17
♥ 2631
pstack 新技能:v0.15.13 上线 /poteto-help! 这个早该做了,不过以后如果你想知道 pstack 能帮你干啥,直接问 /poteto-help 就行!我把自己写过的所有指南都喂给它了,所以只要你拿不准某个 pstack 技能或者 poteto-mode 有没有用——问就完事了!
Tibo
·
10月4日 12:30
37:23
OpenAI’s Head of ChatGPT: We’re entering a new era of AI (again) | Tibo Sottiaux
▶ YouTube · Lenny's Podcast
Tibo
·
10月4日 04:59
♥ 1.5万
好,就这么定了。现在只在做这几件事:简化、更高的效率换来更多用量、突破性功能,或者新模型。有时候必须提前投资,但反馈很清楚,大家都希望东西更简单。正在办。
Tibo
·
10月4日 04:35
♥ 664
它做了什么 - 批量验证并删除了我不需要保留的所有邮件类别 - 识别出我工作类型对应的标签,并对所有邮件进行了分类 - 引导我逐一处理需要回复的邮件,同时在后台搜索相关背景信息,帮我把回复写对 在这个过程中,我处理了大量人们直接发给我的反馈和需求。这是个不错的周六。
Tibo
·
10月4日 04:30
♥ 2974
我这辈子从来没做到过收件箱清零,直到我刚把它设成 dot 的一个主动目标,让它帮我搞定。看看能维持多久吧,不过感觉真爽。
poteto
·
10月4日 00:32
♥ 82
另外,dr eggbot 也可以帮你做一个高质量的工程机器人,全程用 pstack 完成工作!
poteto
·
10月4日 00:31
♥ 4445
人很容易掉进一个坑:去微操你的 agent,而不是去修正塑造它行为的环境。 pstack 0.15.9 现在带了一个新的 /correct 技能:如果你老是因为同样的错误去纠正 agent,它会找出规律,然后用架构、类型和检查把问题修掉。 我喜欢把飞快涌进代码库的 commit 想象成一棵盆景树,想往哪长就往哪长,长得飞快。你要做的不是向混乱投降,而是用对的约束有意识地驯服它 0.15.9 还改进了: • /architect:现在包含如何设计对 agent 友好的架构的说明 • 新增 /benchmark-checklist 技能,基于 @brendangregg 的基准测试清单 这里有个 prompt,你可以丢给 grok bot,用 pstack 开始给代码库搭一个更好的架构: /poteto-mode 创建一个新的 Project agent 来重构并重新设计我的 repo 的架构,让它对 agent 更友好。它要同时用 /correct 和 /architect 技能去翻过去的 commit,找出 agent 最常踩的坑,不管是代码质量、性能还是 bug。如果相关,也可以用 /recall 技能找过去的对话作为上下文。它要做一个高层计划给我审。它也应该通过做原型来回答自己的开放问题,而不是推给我。带着有真实数据支撑的计划回来找我。等我批准计划后,用 stack 或 full autopilot playbook(问我要哪个)去执行
poteto
·
10月3日 05:08
1:05:36
LIVE: Poteto (creator of pstack) on shipping 1,000's of PR's a month at SpaceX
▶ YouTube · Matt Pocock
poteto
·
10月1日 08:35
♥ 79
嘿 @bot 弄完了跟我说一声 我睡了
poteto
·
10月1日 08:33
♥ 983
我把我的脑子给了我的 bot,它完全知道我想要什么。我现在就是这么修 bug 的。
2026年9月
poteto
·
9月27日 13:00
45:04
We Built Grok Bot. Here Are Our 14 Best Bots | Peng Zheng & Lauren Tan
▶ YouTube · Peter Yang
Tibo
·
9月9日 15:56
1:14:22
Building Codex with Tibo Sottiaux
▶ YouTube · The Pragmatic Engineer
2026年8月
Tibo
·
8月24日 18:11
44:28
How to Understand the Next Wave of AI Before Everyone Else | Tibo Interview
▶ YouTube · Matthew Berman
poteto
·
8月13日 22:00
28:41
Are Agents About to Replace Software Engineering? | Lauren Tan and Roshan Sadanani
▶ YouTube · MTS
2026年6月
Tibo
·
6月22日 17:57
39:33
The New Shape of Engineering
▶ YouTube · Datadog
2026年5月
Tibo
·
5月22日 15:30
31:08
Head of ChatGPT & Codex: agents for normal people are HERE
▶ YouTube · Silicon Valley Girl
Tibo
·
5月14日 20:28
43:03
Codex for Everyday Work: AI Agents Beyond Coding
▶ YouTube · OpenAI
看完整时间线 →