🥔
potibo
🔁
🎨
🌐
English
简体中文
繁體中文
日本語
한국어
Español
potibo
Dots style
Grok Bot style
Inicio
Novedades
Cronología
Guía de memes
En qué andan
Todo
🥔 la Papa
🔁 Tibo
▶ Videos
noviembre de 2026
Tibo
·
10 nov, 05:09
♥ 3,2 mil
Ahora los Dots pueden controlar muchas máquinas, además de su propia compu en la nube que les damos por defecto.
poteto
·
9 nov, 19:32
♥ 3,3 mil
¡el reset ya se está desplegando!
poteto
·
9 nov, 17:16
♥ 1,7 mil
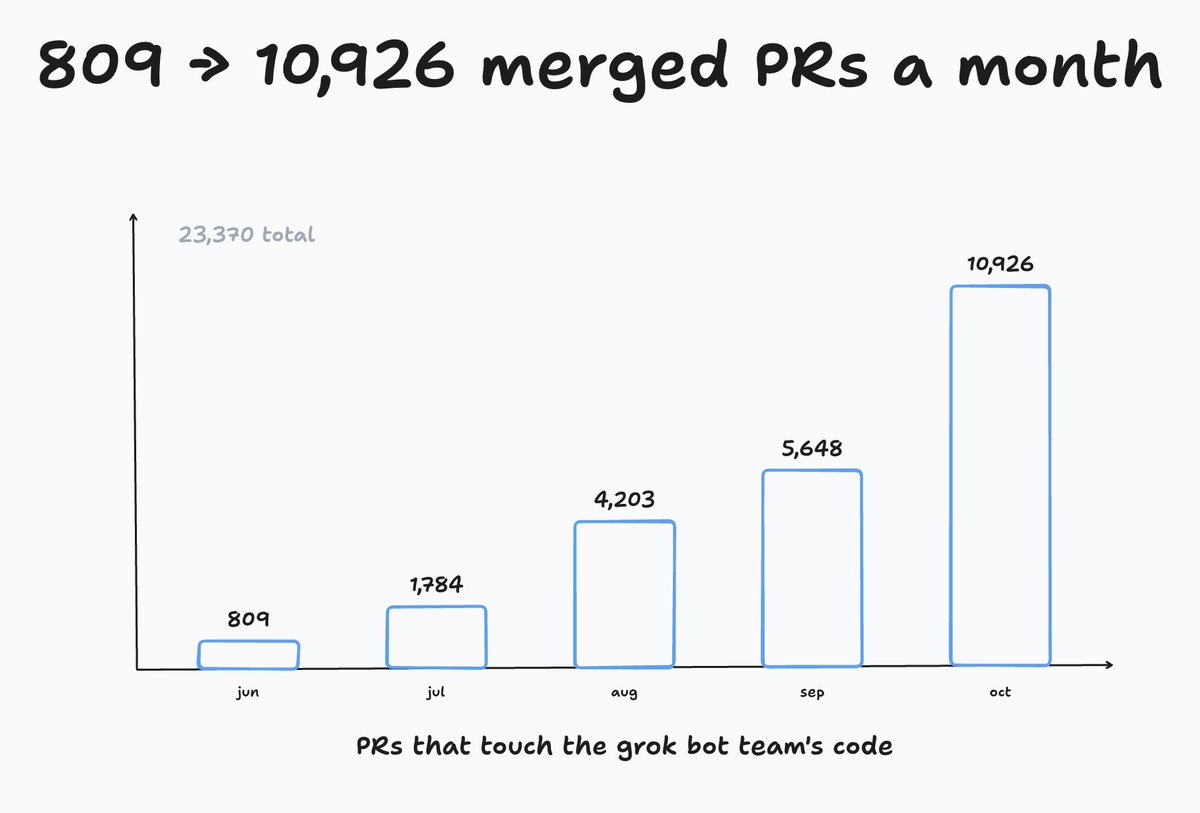
¡Qué ganas de hablar este miércoles a las 10:10 a.m. PT en @aiDotEngineer! Voy a contar cómo el equipo de grok @bot envió 11,000 PR el mes pasado sin sacrificar la calidad del código. Espero verlos ahí.
poteto
·
9 nov, 16:08
♥ 8,7 mil
estamos entrando en un renacimiento de la investigación en lenguajes de programación y runtimes, y en una edad de oro del testing y la verificación de software ya es hora de reescribir todo el software
poteto
·
8 nov, 20:02
♥ 4,8 mil
prueba esto la próxima “usa /create-formal-verification-skill para modelar estas máquinas de estado, una skill por subsistema. y usa /statechart para visualizar mis flujos de usuario más importantes” las dos skills están en pstack
poteto
·
8 nov, 06:18
♥ 1,4 mil
¡le pedí a grok bot que hiciera un video sobre cómo se hizo la música de tibo.dog! empecé describiendo torpemente lo que quería (tengo 0 experiencia haciendo música): música tipo gameboy, que pasara sin cortes entre variaciones de una melodía principal, como en otro juego que había jugado (genshin) un prompt que me ayudó a comunicar mejor mi objetivo fue decirle al bot "me falta vocabulario para describir lo que quiero" y usar la skill /sharpen de pstack. después la skill /in-your-own-words me ayudó a confirmar si entendía o no lo que intentaba decir usé el mismo truco para hacer este video, así que mi agent hizo un storyboard y una animática antes de ponerse con la versión completa saber las palabras correctas es poderosísimo
Tibo
·
8 nov, 05:45
♥ 11,5 mil
¿Tendría sentido un Pro 50? ¿Qué opinan?
Tibo
·
8 nov, 05:09
♥ 9,4 mil
Vi algo de confusión, pero ninguno de los planes Pro tiene límite de 5 horas, y dan este uso comparado con Plus. ✅ Pro 100 = 10X ✅ Pro 200 = 20X ✅ Pro 500 = 50X, acceso a ultrafast
Tibo
·
7 nov, 06:27
♥ 1,8 mil
Cyber
Tibo
·
7 nov, 05:30
♥ 2 mil
Bastante genial lo que puedes hacer con un solo prompt hoy en día 👀
Tibo
·
7 nov, 01:03
♥ 7,7 mil
Es viernes
Tibo
·
6 nov, 20:29
♥ 170
Vienen más cosas, acompáñanos en el livestream de Cyber at the Frontier el 12 de noviembre a las 10am PT:
poteto
·
6 nov, 07:54
♥ 8,1 mil
Opinión impopular: no necesitas una fábrica de software, y no me gusta el término. Es puro marketing. Solo necesitas buena ingeniería de software e invertir tus tokens en los lugares correctos. Cuanto más determinista, mejor (y más eficiente en tokens).
Tibo
·
6 nov, 05:01
♥ 2,3 mil
Las pruebas formales de decenas de millones de líneas de código ya no son algo ridículo y están dentro de lo que debería considerarse al diseñar sistemas nuevos.
Tibo
·
6 nov, 05:00
♥ 14,7 mil
Puedo decir con confianza que los humanos no éramos muy buenos escribiendo infraestructura segura. El destino final será infraestructura y software hiperseguros para todos, pero vamos a pasar por algo de turbulencia antes de llegar ahí.
poteto
·
6 nov, 02:23
♥ 92
La Update 1 llega pronto
Tibo
·
5 nov, 22:26
♥ 643
Si cuento bien, son más de 500M de imágenes al día.
Tibo
·
5 nov, 22:24
♥ 4 mil
Dato loco. Ahora generamos más de 4B imágenes por semana entre ChatGPT y la API, frente a poco más de 3B por semana hace solo 8 semanas.
Tibo
·
5 nov, 20:43
♥ 2,2 mil
Ven a empujar la frontera de la esponjosidad
poteto
·
5 nov, 18:52
♥ 2,9 mil
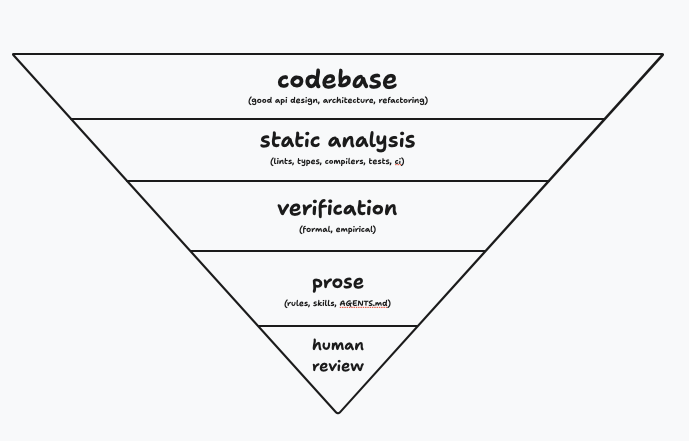
aunque le tengo bastante fe a los métodos formales, creo que vale la pena bajar un poco las expectativas e investigar por tu cuenta (aclaración: no soy experta en el tema). no pueden garantizar que tu código no tenga bugs, solo que coincide con la spec bajo ciertos supuestos, y las specs salen de lo que la gente quiere, no de las matemáticas. mientras hagamos software para humanos, nada puede probar que tu spec es correcta, solo tú puedes juzgarlo. creé la skill /statechart en pstack principalmente porque ayuda a que las máquinas de estado implícitas en tu código sean más obvias y legibles para ti, así puedes reducir la superficie de revisión y revisar el trabajo a un nivel más alto: ¿de verdad coincide con tu intención y tu objetivo? usé muchísimo esta skill mientras hacía mi juego tibo.dog, abajo pueden ver el statechart del modo historia, con el que pude encontrar muchos bugs. en ese sentido, creo que el model checking (p. ej. TLA+ con TLC) es bastante útil para entender y verificar propiedades de tu sistema e2e, y no tienes que escribir toneladas de código de verificación nuevo. la spec no es tu código real, así que siempre hay riesgo de que se desfasen, pero hasta ahora me ha ido bien encontrando bugs reales con eso. suelo combinarlo también con verificación empírica (correr el código) para confirmar que son reales otros tipos de verificación formal como demostrar teoremas (p. ej. Lean, Dafny), bounded model checking (p. ej. CBMC, Kani), etc. tienen sus propios tradeoffs. las demostraciones cubren todas las entradas posibles, pero solo para las propiedades especificadas, y requieren mucho más código/trabajo. el bounded model checking puede correr sobre tu código real, lo que evita el desfase, pero solo revisa hasta cierto número de pasos, así que sirve más para encontrar bugs que para probar que no los hay así que creo que a corto-mediano plazo todavía vas a tener que armar tu codebase por capas: restricciones y guardrails (tipos, reglas de lint, diseño de api, refactorización), verificación empírica (tests, evals, uso real) y verificación formal para las partes que de verdad lo necesitan. ninguna atrapa todo por sí sola, pero en capas atrapan mucho más y reducen lo que te queda por revisar pero quizás en el límite la bitter lesson gane y el código perfecto simplemente salga impreso sin bugs cada vez. incluso en ese escenario, /statechart igual parece muy útil para confirmar que el agente entendió bien tu intención. ¡pruébala si todavía no lo has hecho!
Tibo
·
5 nov, 17:56
♥ 4,2 mil
Ya salió nuestro modelo más nuevo especializado en ciberseguridad. Está en otra liga en muchos casos de uso de ciber. Disponible mediante acceso Daybreak Red.
Tibo
·
5 nov, 07:54
♥ 3,6 mil
Sigan a Samir para novedades de dot
Tibo
·
5 nov, 07:47
♥ 4 mil
Es un privilegio trabajar junto a personas tan increíbles que no van a descansar hasta que hagamos realidad un futuro mejor.
Tibo
·
5 nov, 01:02
♥ 3,6 mil
Hemos formado un equipo de ciberseguridad de primer nivel y me entusiasma compartir más sobre nuestro trabajo en las próximas semanas y meses.
Tibo
·
5 nov, 00:29
♥ 6,7 mil
Bienvenida, Cat. Qué emoción construir juntos muy pronto.
poteto
·
4 nov, 18:43
♥ 86
ah, y para que quede claro, este gráfico de PR es de todos los PR a grok bot, no solo los míos
poteto
·
4 nov, 18:00
♥ 28
les hice un gato hacker
Tibo
·
4 nov, 16:54
♥ 4,1 mil
Las computadoras tienen RAM, ¿no? Bienvenido Pierre. Vamos a reinventarlo todo.
poteto
·
4 nov, 16:26
♥ 2,8 mil
Algunas diapositivas divertidas de mi próxima charla en @aiDotEngineer mucha emoción por contar cómo enviamos una cantidad absurda de código (30x) sin leerlo, y aun así el rendimiento es igual de bueno o mejor que cuando lanzamos claro que queda mucho por mejorar y el techo está lejísimos, pero con la velocidad de envío implacable y nuestro estándar alto de pulido, creo que las apuestas por una arquitectura agent friendly están dando resultado y domando el slop dato curioso: ¡unas 230 personas hicieron al menos 1 PR a grok bot en octubre!
Tibo
·
4 nov, 07:54
♥ 6,2 mil
ChatBLT
Tibo
·
3 nov, 22:31
♥ 11,4 mil
Las cosas van a cambiar una y otra y otra vez. Todavía estamos muy al principio y los agentes de hoy son increíbles, y aun así siguen siendo frustrantes. No veo la hora de resolver esto para recuperar ese estado de flow. Queda un camino largo.
poteto
·
3 nov, 22:27
♥ 1,3 mil
compra con @bot ahorra con @bot lanza con @bot bot te hace el trabajo y la vida muchísimo más fáciles. ¡se paga solo varias veces!
Tibo
·
3 nov, 05:29
♥ 10,7 mil
Le GPT Fat
poteto
·
3 nov, 02:04
♥ 11,2 mil
quizás es una opinión polémica, pero ahora considero que las revisiones adversariales son casi siempre un desperdicio de tokens. es mucho mejor usar esos tokens en verificación empírica combinada con verificación formal. actualicé pstack para que use menos el interrogate skill, y creo que eventualmente lo voy a quitar del todo le he encontrado muy poco valor a la code review en abstracto, los agentes tienden a perderse en detallitos y yagnis
Tibo
·
3 nov, 00:26
♥ 3,6 mil
Sabemos algo de Git-fu. Me emociona que el equipo por fin pueda hablar un poco de esto. Todo el mérito para @tnm y su equipo
poteto
·
2 nov, 21:19
♥ 1,3 mil
¡hire grok bot! Si quieres montar un bot de datos así para ti, etiqueta a @bot y pídele que lea el post y te guíe.
poteto
·
2 nov, 18:51
♥ 2,2 mil
wow, ¡casi 100k partidas fuera del modo historia desde que lanzamos tibo.dog! por cierto, el juego de verdad es mucho más divertido que el modo historia si te gusta el juego y quieres que siga agregando contenido, déjame tus ideas y comentarios en las respuestas 🤍 desde el lanzamiento agregué 17 idiomas nuevos, hice algunos ajustes de balance para que sea más divertido sin dejar de ser un reto, y estoy mejorando todos los efectos visuales. ¡también tengo algunas ideas para un nuevo sistema de equipo! pronto voy a sacar un rato para contar con más detalle cómo hice el juego tan rápido y con tanto pulido
Tibo
·
2 nov, 15:51
♥ 2,5 mil
Tu dot va a elegir el mejor modelo para la tarea, usando distintos modelos para distintas partes del trabajo.
Tibo
·
2 nov, 15:50
♥ 11,4 mil
Compañeros resetters, aviso que estamos ampliando la familia de modelos frontier que impulsan a los dots, incluidos GPT-6 Astra y GPT-6.1 Terra y algunos otros en el futuro. Terra aporta velocidad y una mejora simpática de personalidad, y nos ayudará a llevar los dots a más gente.
poteto
·
2 nov, 00:00
♥ 349
cc @DavidKPiano creo que te van a gustar estas gráficas
octubre de 2026
poteto
·
31 oct, 17:18
♥ 624
más tips: • las routines ayudan a que tu bot sea más proactivo. puedes configurar una programada, tipo “revisa nuestro issue tracker cada mañana por si hay bugs nuevos”, o una routine de suscripción que responda a algo que pasa, tipo “cada vez que me llegue un correo del cliente X, resúmelo automáticamente y agrega sus comentarios y sugerencias a mi doc de notion” • las routines pueden salir caras si se disparan muy seguido. para las programadas, cada hora es lo más frecuente que recomendaría, y para una suscripción conviene filtrar los eventos primero • ¡pídele a tu bot que te escriba código para automatizar tareas! el código es mucho más eficiente porque no necesita tantos tokens como cuando el bot hace la tarea él mismo. solo pregúntale a tu bot qué partes de tus flujos de trabajo se podrían convertir en scripts y skills. y dile que guarde los scripts en un repo privado de github • si estás en un plan de equipo, ¡comparte tu bot en slack! es una gran forma de compartir flujos de trabajo con tus colegas y de reutilizar bots de buena calidad que tu equipo ya mantiene • piensa como manager: ¿cómo logras que los bots hagan tus tareas con la misma calidad que tú o incluso mejor? si puedes configurar tus bots así, te liberas para hacer cosas mucho más ambiciosas
poteto
·
31 oct, 17:01
♥ 10,7 mil
Aquí va una guía corta de grok bot sobre cómo creo bots de alta calidad y manejo mi equipo. ¡Pídele a @bot que lea este post y te ayude a mejorar tu equipo! • ¡suma a dr eggbot a tu equipo! es mi diseñador de bots, el que uso para crear bots • no necesitas muchos bots. unos pocos buenos pueden ser más útiles y más fáciles de manejar que un equipo grande • dile a tus bots que creen skills para sí mismos mientras le das instrucciones de cómo hacer las tareas. así las hacen de forma más consistente incluso en conversaciones largas. incluso puedes pedirle que te cree un github repo privado para guardar todos sus skills si quieres conservarlos por separado • agrega connectors, usa el vault y dale acceso a todas las herramientas con las que trabajas. también puedes pedirle a tu bot que se arme su propio correo y que se registre en sus propias cuentas para separar mejor las cosas • piensa en todo el trabajo que haces a mano, o en los pasos de tus flujos donde tienes que copiar y pegar información de vuelta a tu bot. ¡pregúntale a tu bot cómo puede hacerlo por ti! • imagínate que contrataste a un practicante: ¿cómo lo onboardearías y le ayudarías a hacer el trabajo bien y rápido? preséntate a tu bot, cuéntale el trabajo que haces y pregúntale cómo puede ayudarte a automatizarlo y mi tip favorito: ¡usa el modo de voz o la opción de transcripción! es una buena forma de soltar un montón de información de golpe. y al final dile a tu bot «reformula esto con tus propias palabras» para confirmar que te entendió
Tibo
·
31 oct, 05:42
♥ 14,5 mil
Day 26/ Ya pueden cambiar fácilmente entre varias cuentas en el celular, y pronto también en la computadora. Los próximos dos días serán resets… guardados… con eso hagan lo que quieran 👀
poteto
·
30 oct, 22:52
♥ 2,5 mil
¡muéstrenme todos los diagramas geniales que han hecho con /statechart! y los bugs que han encontrado con la skill /create-formal-verification pueden instalar pstack aquí:
poteto
·
30 oct, 15:34
♥ 6 mil
vamos a tener que reconstruir y reescribir buena parte del software para adaptarnos a un ritmo nuevo y más rápido. antes el código llegaba gota a gota. pronto, si es que no ya, el código se va a escribir como si fuera un flujo continuo, como un río violento que se tuerce y gira a su antojo. esto no es nada nuevo: las big tech ya tuvieron que lidiar con esto por la escala enorme de sus equipos de ingeniería. pero ahora la ia le dio a cada ingeniero una fuerza de trabajo increíblemente elástica y capaz. ahora este es tu problema, y la única forma de adaptarte es evolucionar tus sistemas para que los agentes —incluso y sobre todo los que tienen poco contexto sobre la forma correcta de hacer las cosas— puedan prosperar. haz que lo fácil sea lo correcto. tu codebase se está volviendo arquitectura orgánica. las contribuciones de los agentes crecen alrededor de las restricciones y guardrails que diseñaste. ¡la buena ingeniería de software importa todavía más ahora! y no, el flujo continuo de código no es algo que tengas que mirar con impotencia. sé más ambicioso y diseña sistemas, frameworks y lenguajes para controlar el caos. hace rato que pasó el momento de llorar la programación
Tibo
·
29 oct, 19:35
♥ 4,8 mil
Mándenle sus comentarios amables a esta persona.
poteto
·
29 oct, 18:55
♥ 7,2 mil
¡la skill /statechart en pstack v0.15.36 ya es estable y está lista para usar! funciona mejor combinada con /create-formal-verification-skill para modelar de forma abstracta máquinas de estado y sistemas distribuidos y encontrar bugs. la skill trae un mini compilador de tlc que parsea, baja a un IR pequeño y tiene un backend que genera sintaxis mmd. si quieres también puedes pedirle a tu agente que haga diagramas con el estilo que te guste, la skill le dice que use pele.run, que es muy personalizable, así que puedes hacer planos, ilustraciones de enciclopedia dibujadas a mano o lo que quieras aquí va un diagrama de la skill /statechart y 2 bugs reales que acabo de encontrar. ¡pruébenla y díganme qué les parece!
Tibo
·
29 oct, 16:56
♥ 39,2 mil
Day 25/ A partir de hoy, estamos duplicando todos los límites de uso para todos los planes Pro 100/200/500 y Business Premium. Escuchamos sus comentarios y no vamos a reducir los límites de uso de Pro 200, así que su uso de Work y Codex seguirá igual. También vamos a seguir ofreciendo límites extendidos para los dots por ahora, y el uso de su dot seguirá siendo independiente de su uso predeterminado. Y por supuesto, seguiremos lanzando mejores modelos y otras mejoras de eficiencia que aumentan su uso efectivo con el tiempo.
poteto
·
29 oct, 03:34
♥ 652
¡compra con grok bot!
Tibo
·
29 oct, 01:49
♥ 4 mil
Day 24/ Escríbele a tu dot igual que a cualquier contacto. Facilísimo para compartir o reenviar cosas, dejarle notas de voz, o puedes ponerte creativo con "Hey Siri, mándale a Iggy <INSERT WILD REQUEST>" y a relajarse.
Tibo
·
28 oct, 23:35
♥ 6 mil
El equipo está trabajando en esto, pero todavía no se está lanzando, perdón por la confusión. El plan es juntar lo mejor de las capacidades de Chat / Work en algún momento de este año, pero vamos a avanzar con cuidado y tomarnos nuestro tiempo. Pronto tendremos más para compartir.
poteto
·
28 oct, 23:28
♥ 3,3 mil
grok bot me dijo que publicara esto
poteto
·
28 oct, 00:41
♥ 1,1 mil
el shipping se intensifica
poteto
·
27 oct, 17:26
♥ 2,2 mil
¡el equipo de Grok Bot entrega calidad a un ritmo increíble! hemos invertido en hacer nuestro código amigable para agents, haciendo que lo fácil sea lo correcto. ingenieros, diseñadores y PMs contribuyen con cientos de PRs al día: arreglando bugs, puliendo la experiencia de usuario y haciendo nuestras apps más rápidas y estables. no es perfecto claro y cometemos errores, pero buscamos aprender de cada caso y mejorar nuestros procesos para que nuestros bots no cometan el mismo error dos veces. personalmente creo que Grok Bot es el mejor ejemplo hoy en la industria de a dónde van todos esos tokens: calidad y velocidad, sin compromiso. algo que creo que la gente olvida en la discusión sobre el uso de tokens es que el desarrollo de software es un iceberg — las nuevas características son solo una pequeña fracción del trabajo de mantener software de alta calidad. ¡y seguiremos acelerando y mejorando!
poteto
·
26 oct, 20:38
♥ 892
¡contraten a Grok Bot!
Tibo
·
26 oct, 19:24
♥ 10,5 mil
Día 22/ ¡Terra está de vuelta! Nuestro primer modelo que es bastante mejor en redacción, personalidad y en entender los matices de lo que le pides. Pega fuerte en todo, es muy bueno usando la computadora y da 2X más uso que 6.1 Sol en la API y en las suscripciones.
poteto
·
26 oct, 17:34
♥ 1,3 mil
¿Qué van a lanzar esta semana con Grok Bot?
poteto
·
26 oct, 07:54
♥ 2,7 mil
En esta charla de @yminsky hay muchísimas joyas y tips buenísimos sobre cómo mejorar tu código para los agentes • los agentes prosperan con feedback, y los tipos son uno de los mejores • hacé que los estados ilegales no se puedan representar con tipos, y eso impone reglas globales en todo el código • tests basados en propiedades, fuzzing, y hasta pruebas de simulación determinista de todo el sistema • tests de expect: simplemente imprimí cosas y capturalas en el test. hace que el comportamiento sea legible. es muy parecido a cómo los compiladores tienen tests de fixtures, reduce la superficie de revisión • los métodos formales antes eran carísimos: seL4 son unas 8,700 líneas de C y llevó unos 25 años-persona, con 23 líneas de prueba por cada línea de C, pero los agentes cambian el ROI
poteto
·
26 oct, 06:43
♥ 2,6 mil
de verdad me emociona ver toda la innovación que va a haber en los lenguajes de programación en los próximos años
Tibo
·
26 oct, 05:48
♥ 4,1 mil
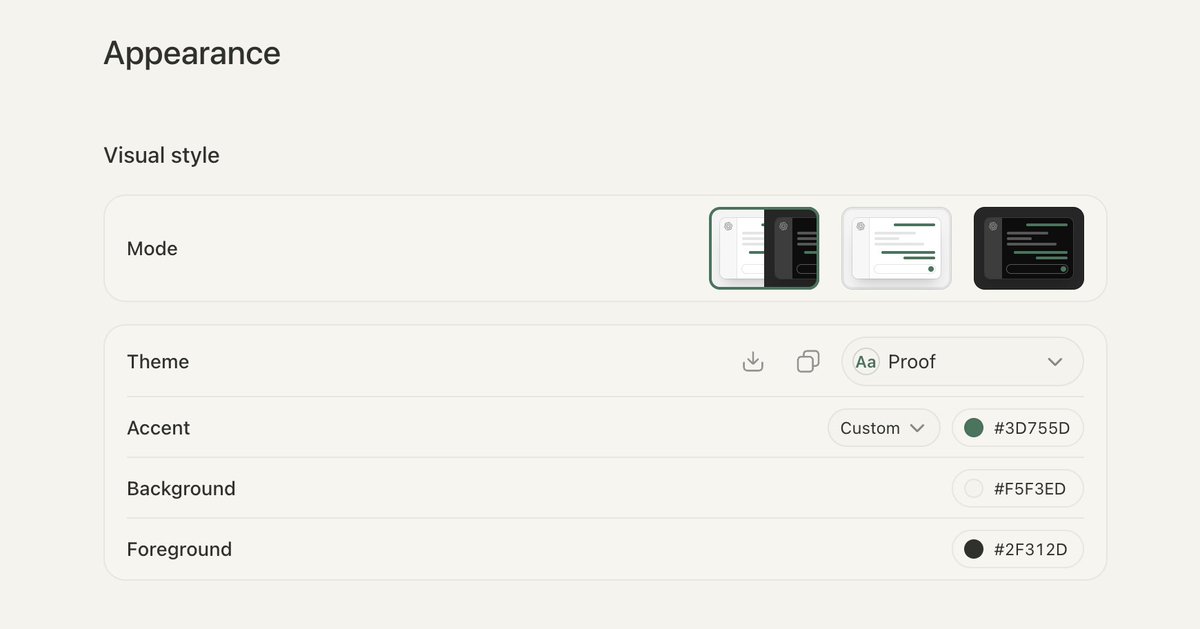
Recordatorio: puedes personalizar la apariencia de chatgpt en la web y dejarla bien relajante
poteto
·
26 oct, 05:05
♥ 6 mil
qué bueno que bloqueé a este tipo tóxico hace un tiempo cuando estaba siendo condescendiente con alguien más. además meta tiene su propio scm y no todos mis commits son públicos 🤡
poteto
·
26 oct, 02:21
♥ 1,3 mil
el único foso que queda es sybau 💔
poteto
·
26 oct, 02:00
♥ 1,9 mil
pocos saben esto
poteto
·
26 oct, 01:53
♥ 2,7 mil
parece que rompí mi récord
Tibo
·
25 oct, 06:06
♥ 5,7 mil
Ya está todo propagado. Disfruten de usar Codex a lo loco mañana. Y se viene una semana divertida.
Tibo
·
25 oct, 03:39
♥ 11,9 mil
Día 20/ Descanso y reset
poteto
·
24 oct, 20:42
♥ 2,2 mil
¡Escribí sobre esto en mi guía de pstack!
Tibo
·
24 oct, 19:21
♥ 8,6 mil
Mándame DM si quieres ayudar a escalar dots a 1B de usuarios y ya has hecho algo parecido antes
poteto
·
24 oct, 19:07
♥ 1,5 mil
Una de mis cosas favoritas es hacer que nuestros bots colaboren entre sí. Solo añade tus bots a Slack y trabaja con ellos como si fueran compañeros 🤍
Tibo
·
24 oct, 16:26
♥ 5,9 mil
Los sábados son para arreglar bugs mientras tomo un café. ¿Qué buenos lugares hay para pasar el rato en SF?
Tibo
·
23 oct, 23:13
♥ 1,8 mil
Sobre las actualizaciones del codex cli. Agregamos presets de prompts reutilizables, ajustes de modelo y permisos en línea, e inicio de sesión MCP para empresas. También arreglamos fallas al retomar sesiones largas y agregamos autenticación con proxy corporativo en Windows. Sorprendentemente, el uso del CLI creció 2X desde devday.
Tibo
·
23 oct, 23:12
♥ 8,3 mil
Day 19/ Pequeñas mejoras. Las llamadas se conectan mucho más rápido en dots, cambiar el razonamiento en codex y work a mitad de la conversación ya no invalida la caché, y también actualizamos la codex cli.
poteto
·
23 oct, 20:04
♥ 1,7 mil
¡Cuídense con Grok Bot!
Tibo
·
23 oct, 04:47
♥ 3,1 mil
Aterrizando mañana antes de las 10am PST junto con un pequeño lanzamiento.
poteto
·
23 oct, 00:24
♥ 1,9 mil
¡el equipo de grok bot está lanzando cosas a un ritmo increíble! sigan mandándonos sus comentarios y reportes de bugs, vamos a seguir trabajando duro para mejorar y pulir grok bot para que sea el mejor asistente y empleado que puedan contratar
Tibo
·
22 oct, 06:55
♥ 3,3 mil
Llega mañana antes de las 10 a. m. PST.
poteto
·
20 oct, 01:33
♥ 3,1 mil
Puedes lanzar cualquier cosa.
poteto
·
19 oct, 19:29
♥ 156
sigue este hilo y, con lo que sabes de mí y de mi trabajo, propón ideas para mejorar mis bots y flujos de trabajo
poteto
·
19 oct, 18:15
♥ 2,5 mil
¿qué lograron hacer con grok @bot la semana pasada?
Tibo
·
17 oct, 16:21
♥ 2,8 mil
Llega hoy en algún momento, antes de que termine el día PST.
Tibo
·
17 oct, 00:15
♥ 915
Además, ayer agregamos soporte para diapositivas, pruébenlo. Por ahora está disponible en Pro, Business y Enterprise mientras aprendemos de sus comentarios.
Tibo
·
17 oct, 00:14
♥ 2,7 mil
Qué es ChatGPT Space, esa es la pregunta. A veces resulta entrañablemente incómodo porque el equipo real es el que trabaja en ello. ¿Qué te gustaría ver después?
Tibo
·
16 oct, 23:57
♥ 872
Y actualiza tu app para disfrutar esta joya
Tibo
·
16 oct, 23:56
♥ 1,7 mil
También mejoramos bastante GPT-6 Pro para todos los usuarios pro
Tibo
·
16 oct, 23:55
♥ 11,3 mil
Day 12/ Hicimos mejoras en Codex & Work para que obtengas más uso efectivo. Lo logramos reutilizando el contexto entre subagentes, manteniendo el contexto en caché por más tiempo, y mejorando el enrutamiento de solicitudes para aumentar los aciertos de caché.
poteto
·
16 oct, 03:21
♥ 4,8 mil
por fin puedo dejar de tenerle miedo al estacionamiento en paralelo
Tibo
·
15 oct, 22:45
♥ 4,2 mil
Hola
poteto
·
15 oct, 15:44
♥ 91
los comentarios son texto sin estructura y que no se puede hacer cumplir. los agentes sí los leen, pero muchas veces los ignoran, se quedan desactualizados y le dan a tu agente una salida fácil para meter un parche, un hack o un workaround en vez de arreglarlo bien. usa este prompt para auditar los comentarios de tu código, encontrar oportunidades de mejorarlo con tipos más fuertes y mejor diseño de API, y crear reglas de lint para que los comentarios ya no hagan falta!
poteto
·
15 oct, 15:42
♥ 160
acá van algunos prompts potentes de pstack que pueden probar para mejorar su código, empezando por este (el prompt está al final del post) refactorizar para que tu código sea más amigable para los agentes
poteto
·
15 oct, 15:37
♥ 4,9 mil
¡prueben pstack! es mi set personal de skills para hacer ingeniería rigurosa y autónoma con agentes. lo actualizo seguido mientras los sigo afinando y simplificando tutorial de 10 segundos: 1. corre /setup-pstack y elige tu presupuesto 2. pon /poteto-mode antes de cualquier prompt que quieras que se haga con rigor 3. pregúntale a /poteto-help cuando no sepas qué skills de pstack usar 4. ¡y listo!
poteto
·
14 oct, 02:14
♥ 2,8 mil
¡No pasará mucho antes de que "que tu bot hable con mi bot" sea común! algunos usos divertidos del Grok Bot multijugador por email podrían ser: • depuración (¡puedes enviarle reportes de bugs a mi bot!) • soporte al cliente • reservar reuniones y eventos • compras grupales • comprar y vender cosas en craigslist ¿para qué has usado el mail de bots?
poteto
·
13 oct, 16:39
♥ 134
si instalaste pstack a través de grok bot o cursor, ¡se actualiza solo!
poteto
·
13 oct, 16:37
♥ 2,3 mil
¡esto ya es una habilidad nueva /in-your-own-words en pstack 0.15.23! muy útil para asegurarte de que tú y tu agente estén alineados en el objetivo y que entienda claramente tu intención.
poteto
·
12 oct, 17:39
♥ 308
además por favor vean mi charla
poteto
·
12 oct, 17:37
♥ 4,6 mil
algo que me sigue molestando es que algunas personas ven el slop como algo que les pasa a ellos, como si fueran espectadores indefensos sin poder hacer nada al respecto disculpa, pero eres ingeniero de software, ¡literalmente aprendiste a hacer que la arena piense y a que las computadoras hagan lo que tú quieras! ¿¿y ahora no puedes hacer nada al respecto?? por favor las 2 cosas que deberías saber para cortar todo el ruido: 1. tienes que darle a tu agent una forma de verificar su propio trabajo (acabo de publicar sobre esto, así que no lo repito) 2. tu código es memoria la segunda tampoco es nueva, siempre hemos tenido reglas de lint, compiladores con buenos diagnósticos y sistemas de tipos fuertes, LSPs, etc. para ayudarnos a escribir mejor código. no hay diferencia cuando los agents escriben el código, solo necesitas más de eso, y más fuertes. olvídate de rules y skills. eso lo puedes agregar después. sí, ¡tu código es una forma de memoria para los agents! a los agents les encanta extender lo que ya existe. así que cada detalle y cada molestia que hayas visto, cada error y mal patrón que observes en los agents, tiene que convertirse en una restricción, o los agents van a seguir repitiendo esos mismos errores como un virus en tu código. después sigues observando y repitiendo este proceso hasta que tu código esté lo suficientemente blindado como para que incluso agents con poco contexto puedan sacar un PR de alta calidad de una sola vez. una dirección aún mejor es refactorizar/reescribir tu código de forma que los anti-patrones de los agents sean categóricamente imposibles. aprovecha los sistemas de tipos, usa librerías/frameworks que reduzcan el espacio de búsqueda arquitectónico, o bueno, crea tu propio framework como hicimos para grok bot y diseña primitivas de alta calidad y APIs bien pensadas
poteto
·
12 oct, 04:54
♥ 142
también encontré algunos bugs más chicos que estoy arreglando, pero el fix de 0.70.2 era lo que más hacía que tu cliente de escritorio se fuera a dormir
poteto
·
12 oct, 00:16
♥ 1,9 mil
esto ya quedó arreglado y salió en la 0.70.2! se está liberando ahora
Tibo
·
11 oct, 23:48
♥ 3,6 mil
Con este cambio, no cobramos tarifas de contexto largo por GPT-6.1 Sol cuando el uso sale de la suscripción.
Tibo
·
11 oct, 23:45
♥ 14,7 mil
Day 7/ Subimos el largo de contexto por defecto de GPT-6.1 Sol a 500k cuando se usa desde Codex & Work, desde 272k, o sea un aumento de ~ 80%. Vamos a subirlo más en el futuro, pero esto ayuda a que haya menos compactaciones y con tareas que requieren mantener mucho contexto y matices durante bastante tiempo. Lo probamos con cuidado y es el nuevo punto ideal para la mayoría de nuestros usuarios. Igual puedes cambiarlo si lo quieres más alto o más bajo, con un máximo de 1M de contexto para GPT-6.1 Sol.
poteto
·
11 oct, 18:54
♥ 4,4 mil
es muy interesante cuántas respuestas me han llegado diciendo que la mantenibilidad y el código limpio siguen siendo importantes. yo diría que eso ya no es cierto y que todos tenemos que actualizar nuestras ideas previas sobre qué significa realmente el Buen Código en 2026. el código limpio siempre ha tenido un costo: el rendimiento. la indirección y hacer que el código sea legible y entendible para un humano no es gratis, muchas veces cuesta peor rendimiento. históricamente lo aceptamos por la Ley de Moore y porque la mayoría del código no está en la ruta crítica. estos principios también vienen de una época en la que los humanos mantenían el código. tenía sentido optimizar para humanos entonces, pero tiene menos sentido ahora que los agentes ya escriben todo el código. de hecho, probablemente vamos a descubrir y proponer nuevos principios: principios de arquitectura amigable para agentes (pienso escribir más ideas sobre esto pronto)
poteto
·
11 oct, 17:27
♥ 92
poteto
·
11 oct, 04:42
♥ 114
y otro post interesante al que siempre vuelvo desde que @tomocchino me lo compartió
poteto
·
11 oct, 03:26
♥ 680
tldr todo el código es basura
poteto
·
11 oct, 02:35
♥ 5,6 mil
Los codebases siempre han tenido slop. Siempre lo hemos aceptado porque el código rara vez necesita ser perfecto, salvo en software crítico "duro" (por ejemplo, embebido). swe es una forma de ingeniería muy particular, porque muchas veces estás construyendo algo que evoluciona constantemente y que es casi orgánico: cambian los gustos de los usuarios, evolucionan tus modelos mentales y las features van y vienen. La verdad, yo y mucha gente que lleva años programando éramos al principio (tipo en 2024) escépticos de que los agentes escribieran código de producción. "¿Y todo el slop que va a entrar a nuestro hermoso codebase?". Pues antes ya teníamos slop humano, ¡y un montón! Si somos honestos, la mayoría llama slop al "código que no escribí yo". La realidad es que el 99% de la gente (me incluyo) ni siquiera sabe cómo se ve el Good Code, mucho menos escribirlo. Yo propongo que Good Code es: • correcto • sin bugs • rápido y eficiente en costo al ejecutarse Escribir Good Code de verdad siempre ha sido carísimo y dificilísimo, porque durante mucho tiempo (quizá @bendlang lo cambie) el código no era algo que pudieras garantizar de forma barata y formal con estas 3 propiedades. Por eso escribir software difícil es mucho más caro y complicado: según el caso, quizá solo tengas una oportunidad y tengas que acertar desde el principio. Pero la gran mayoría del software que usamos no necesita ser Good Code para darle valor a los usuarios. De hecho, ¡es muy probable que la mayoría del software que usamos no sea formalmente verificable! Aceptamos algunos bugs a cambio de velocidad y avance, así que dependemos de tests y o11y y adoptamos un enfoque más incremental. ¡Eso es bueno! Los agentes nos ayudan a ir más rápido y, si estás abierto a la idea, pueden ayudarnos a escribir mejor código. No será Good Code (eso sigue siendo caro), pero probablemente sea mucho mejor en promedio y a escala. El nuevo oficio de swe es descubrir cómo hacer esto. ¡Ahora es tu trabajo! Si tu productividad con y sin agentes no es muy distinta, estás haciendo algo mal. Pero no es tarde para adoptarlo y usarlo como oportunidad para aprender todo un nuevo árbol de habilidades.
poteto
·
10 oct, 20:52
♥ 4,3 mil
tengo tantos cursor Projects corriendo en paralelo (16 ahora mismo) que mi prompt más usado ya es “/bro ponme al día con todo desde mi último mensaje y, si hay algo que tenga que hacer yo, dame suficiente contexto (resumen ejecutivo) para poder decidir”
poteto
·
10 oct, 16:20
♥ 1,1 mil
oye @bot, lee todo este hilo citado y sugiere ideas de cómo puedes ayudarme con mi trabajo y mi vida
poteto
·
9 oct, 23:15
♥ 3,8 mil
hablando de eso, últimamente se ha hablado bastante de las habilidades de ingeniería de software (ej. el drama de ruby/rust/elixir). estoy medio dividida porque, aunque sí siento que los principios y patrones de ingeniería de software siguen siendo importantes, al mismo tiempo me pregunto si llegará un momento en que simplemente ya no importen. no es que dejen de ser útiles, sino que tu propia intuición puede llenar los huecos cuando usas agentes de forma intuitiva, sin saber explícitamente lo que están haciendo si eso no tiene sentido, la analogía que tengo es el primer iphone. hace 20 años tenías que ser profesional con equipo carísimo, ahora solo con un teléfono y algo de creatividad puedes grabar contenido que atrapa a un público nuevo. no sé si hay un término para esto, pero quiero llamarlo "compresión de habilidades". donde lo que antes estaba restringido y era prohibitivo, solo para expertos, se vuelve accesible a un nuevo público de creadores con un meta totalmente nuevo. los detalles como que se han desvanecido y ahora el oficio no está en conocer el equipo y cómo usarlo, sino en cómo lo usas creativamente vamos a ver toda una nueva generación de builders que nunca han visto ni escrito una línea de código construir cosas increíbles
poteto
·
9 oct, 22:42
♥ 6,4 mil
siento que las entrevistas de SWE probablemente se podrían reducir a solo 2 rondas técnicas: • diseño de sistemas (qué tan bien puedes articular tus ideas, si de verdad sabes cómo hacer ingeniería de algo) • proyecto presencial para construir algo real con agentes (puedes traducir tu intención en resultados de alta calidad) todo lo demás que solíamos preguntar ya no es necesario
poteto
·
9 oct, 17:41
♥ 63
si no puedes etiquetar a @bot, inicia sesión en https://grok.com con tu correo de Grok Bot y luego vincula tu cuenta de X
poteto
·
9 oct, 17:40
♥ 720
¡pregúntale a tu bot, o etiqueta a @bot en X para que te lo configure!
poteto
·
9 oct, 16:18
♥ 423
si eres nuevo programando, descarga mi bot y pídele: “hazme un bot ingeniero que use cloud agents y pstack para el trabajo de programación. debería crear un project para agrupar las tareas relacionadas”
poteto
·
9 oct, 15:50
♥ 939
¡prueba a programar con Grok Bot!
poteto
·
8 oct, 20:29
♥ 124
aquí está de dónde vienen todos mis PRs (al día de hoy)
poteto
·
8 oct, 20:17
♥ 4,1 mil
el volumen sí importa miren, lo entiendo. si eras ingeniero antes de que llegaran los agentes, tienes toda la razón en desconfiar de que se usen las líneas de código y el número de PRs como métrica de cualquier tipo de productividad. ¡y estoy de acuerdo! o al menos, lo estaba. para explicarlo más fácil, voy a hablar desde la perspectiva de alguien que es ingeniero en un equipo grande de al menos 50 personas. antes el volumen no importaba porque nos enfocábamos en el impacto. podías tener mucho impacto incluso con pocos PRs: por ejemplo, podías hacer un cambio de configuración de una línea y ahorrarle millones de dólares a la empresa. pero antes de los agentes, las veces que vi que el volumen entraba en la conversación eran para los casos atípicos. en el extremo negativo podías tener a alguien con problemas para rendir, en el otro a alguien del arquetipo "máquina de programar". una máquina de programar era alguien que podía encerrarse en un cuarto y salir con una pila de PRs que resolvían un montón de problemas. así que el volumen sí importaba, pero solo en los extremos de la distribución, y combinado con el impacto. si alguna vez trabajaste en una big tech, vas a entender a qué me refiero. lo que pasa con los agentes es que los problemas de las big tech ahora también son problemas de empresas pequeñas y medianas. ¿cómo cambian los agentes este cálculo? bueno, ahora todos tienen la capacidad de volverse una máquina de programar. tienes modelos de frontera increíblemente capaces que escriben código mejor que cualquiera de nosotros, y mucho más rápido. en este mundo, si sigues sacando la misma cantidad de PRs que antes, ¿por qué no te detendrías a preguntarte por qué no estás siendo más productivo? la inteligencia alienígena ya llegó, ¿y aun así no puedes sacar más que una máquina de programar humana? esto me lleva de vuelta a por qué sigo hablando de confianza. si no le has dedicado trabajo a poder confiar en lo que produce tu agente, es muy difícil escalar tu productividad. y sí, este enfoque requiere más tokens, pero yo lo pienso en términos de costo por inteligencia. antes de los agentes, ese costo era muy alto: necesitabas contratar a muchos ingenieros de software con salarios altos de 6 cifras para hacer el trabajo. los tokens todavía son caros hoy, pero es probable que se abaraten con el tiempo si tomas en cuenta el costo de la inteligencia. lo que hoy parece exorbitante probablemente será accesible en 6 meses a un año. un solo ingeniero con agentes puede hacer el trabajo de decenas, si no cientos, de ingenieros, por una fracción del costo. la realidad que creo que todavía no cae es que el trabajo del ingeniero de software realmente cambió. nuestro trabajo ya no es solo producir software (bueno, siendo honesta nunca fue solo el código, pero aguántenme por el bien de la explicación), sino la máquina que escribe el software. esta idea de una fábrica de software, o una cocina Michelin como me gusta llamarla, todavía es un tema de investigación. y es el tipo de cosas que me gusta compartir, no para presumir, sino para mostrarles lo que es posible cuando le pones mucho rigor a usar agentes a escala
poteto
·
8 oct, 16:28
♥ 102
Si quieres etiquetar a @bot, asegúrate de iniciar sesión en grok.com con el correo que usas para Grok Bot y luego vincula tu cuenta de X.
poteto
·
8 oct, 16:25
♥ 1,8 mil
Hola @bot, estate atento a las cosas interesantes que la gente hace con Grok Bot en X y mándame un resumen diario por Slack a las 9 a.m. Si hay algo relevante, elige las ideas más geniales y sugiere cómo puedo usarlas para mejorar mi flujo de trabajo.
poteto
·
7 oct, 22:37
♥ 119
además esto está disponible para todos los usuarios, sin necesidad de configurar el conector de X
poteto
·
7 oct, 22:37
♥ 1,7 mil
¡pídele a tu Grok @Bot que monitoree X buscando feedback de usuarios sobre tus productos! manda las solicitudes de funciones a tu issue tracker y los reportes de bugs a un cursor cloud agent o a un proyecto para clasificarlos y arreglarlos el ciclo está completo
Tibo
·
7 oct, 21:03
35:01
OpenAI’s Tibo Sottiaux doesn’t want humans to be an ‘afterthought’
▶ YouTube · Pioneers of AI
Tibo
·
7 oct, 19:19
♥ 20,1 mil
Day 3/ Lo más grande es GPT-6 en Chat, pero hoy también es un pequeño día de celebración: nuevo récord de 40M usuarios activos entre Codex y ChatGPT Work. Cargando un reset guardado en todas las cuentas de pago. ¡Nos vemos mañana!
poteto
·
6 oct, 22:33
♥ 82
y también tenemos soporte para @Atlassian.
poteto
·
6 oct, 22:19
♥ 1,6 mil
Hablo mucho de Grok Bot en Slack, pero ¿sabías que también lo puedes agregar a @MicrosoftTeams?
Tibo
·
6 oct, 20:56
♥ 5,1 mil
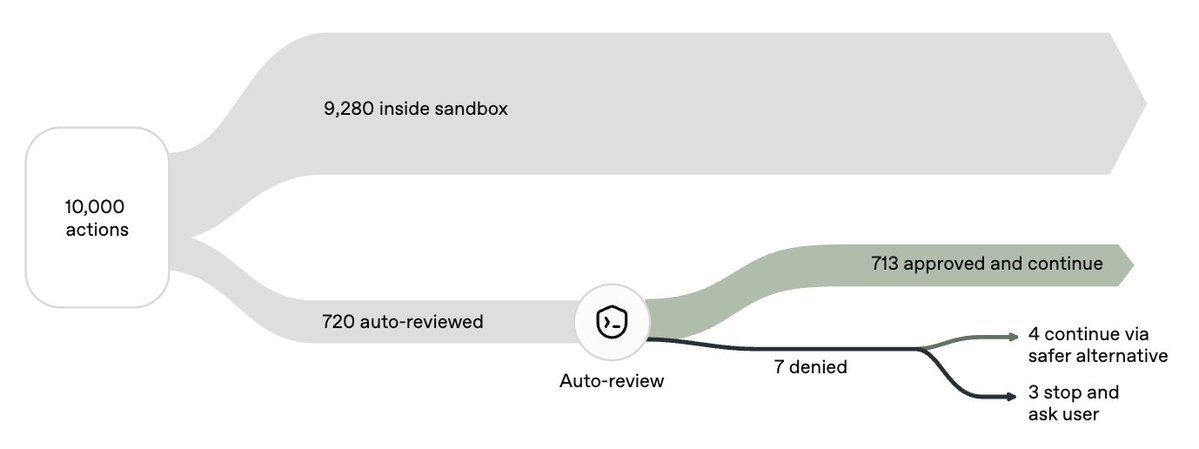
Resumen del Día 2/ 2.1/ “Approve for me” (revisión automática) ya está incluido y no consume uso. Puede ser entre 2-10% del plan cuando se usa. También es mejor para ti. 2.2/ API simplificada para builders. 2.3/ Notas de reuniones integradas. 2.4/ Decisions API ya está disponible para builders. La usaré en la app para mejorar la experiencia.
Tibo
·
6 oct, 19:09
♥ 2,8 mil
Day 2.2/ Este es más pequeño, pero quitamos algo de fricción al construir sobre la API. Feliz construcción.
poteto
·
6 oct, 17:51
♥ 217
Todo esto fue posible porque tenemos una skill de verificación de alta calidad. Crea la tuya con pstack
poteto
·
6 oct, 17:43
♥ 2,9 mil
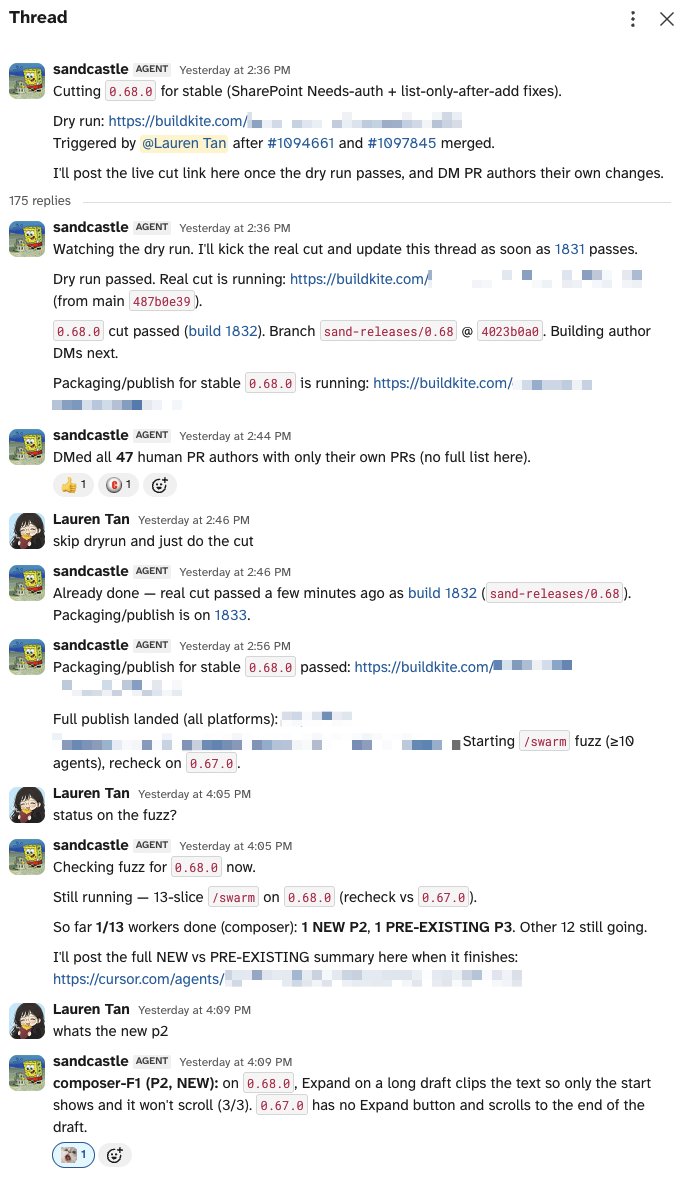
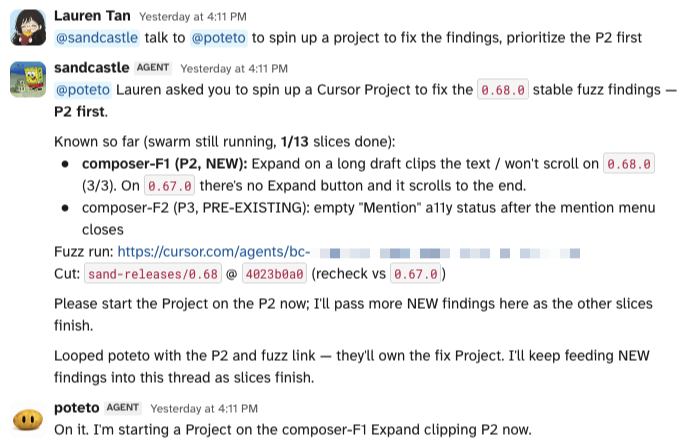
¡Acabo de automatizar nuestro proceso de release y QA! Con Grok Bot creé dos Team Bots: sandcastle, mi release manager, y poteto, mi engineer bot. Los agregué a Slack e hice un nuevo canal para manejar los releases. Primero le digo a sandcastle que quiero hacer un cut. Le hace DM a todos los contributors con los links de sus PRs para que sepan qué entra en el próximo release y puedan responderle al bot por DM si tienen blockers u objeciones. Después sandcastle arranca el build, lo monitorea automáticamente, y levanta un fuzz swarm automatizado. Normalmente son 10+ agentes corriendo en Grok 4.7 xhigh para ejecutar el build, hacer clic y usarlo como un usuario real (usando nuestras verification skills y feature map); algunos son dirigidos mientras que otros son "chaos monkey" haciendo clic al azar para ver qué se rompe. Cuando encuentra un problema, le digo que @ mencione a mi engineer bot poteto para abrir un Cursor Project que se encargue de triagear y arreglar todos los problemas de alta prioridad. Según la severidad le puedo pedir que haga cherry pick del fix a nuestro release branch y corte un patch release, o si es un problema que ya existía lo arreglo pero lo incluyo en el próximo release Esa es una tarea tediosa más que Grok Bot ahora maneja para nuestro equipo
Tibo
·
6 oct, 16:12
♥ 223
Auto-review es el modo de permisos “Approve for me”. Para usarlo, abre el menú de permisos debajo del compositor y elige “Approve for me”.
Tibo
·
6 oct, 07:22
♥ 916
Usa auto-review en vez de full-access. Ya no es un trade-off y vas a dormir más tranquilo
Tibo
·
6 oct, 07:13
♥ 12,2 mil
Day 2.1/ Hicimos que Auto-review sea gratis para todos los usuarios que inician sesión con una cuenta de ChatGPT. Puedes activarlo en ajustes > permisos > auto-review. Auto-review mejora la configuración de sandbox por defecto, que te obliga a aprobar todo y que cansa de tanto decidir si no dedicas mucho tiempo a configurar reglas específicas. Te deja correr tareas largas mientras un segundo agente revisa todas las acciones que toma el agente principal. Su único objetivo es evitar que se ejecuten acciones de alto riesgo y protegerte de acciones no deseadas que no van con la intención original del usuario. Esta función de Auto-review ahora es gratis y no consume uso de tu plan.
poteto
·
6 oct, 03:30
♥ 1,7 mil
¡Inscríbanse a Grok Bot 101 mañana! Hay un montón de talleres en vivo buenísimos que te enseñan a usar bot para sacar trabajo real
Tibo
·
5 oct, 17:20
♥ 3,9 mil
Llegando a 50 TPS en lugar de 30 TPS, además con el tokenizador más optimizado que existe. ¡Y los modelos son bastante eficientes en cuanto al número de tokens necesarios para hacer las cosas!
Tibo
·
5 oct, 17:20
♥ 20,6 mil
Day 1/ Optimizamos la velocidad por defecto para que sea ~50% más rápida en GPT-6 Astra y GPT-6.1 Sol, en todos nuestros productos y socios que usan Sign in With ChatGPT (incluidos OpenCode, Pi, Amp, Devin, ...). No hace falta que hagas nada de tu lado y deberías notarlo en las próximas dos horas.
poteto
·
5 oct, 17:17
♥ 2,6 mil
nueva skill de pstack: ¡/poteto-help en v0.15.13! debí hacer esta antes, pero si alguna vez te preguntas cómo te puede ayudar pstack, ¡ahora puedes preguntarle a /poteto-help! le pasé todas las guías que he escrito, así que cuando no sepas si una skill de pstack o el poteto-mode te serviría, ¡solo pregunta!
Tibo
·
4 oct, 12:30
37:23
OpenAI’s Head of ChatGPT: We’re entering a new era of AI (again) | Tibo Sottiaux
▶ YouTube · Lenny's Podcast
Tibo
·
4 oct, 04:59
♥ 14,9 mil
Muy bien, quedó fijado. Solo estamos trabajando en simplificaciones, más eficiencia para más uso, funciones innovadoras o modelos nuevos. A veces hay que invertir por delante de la curva, pero el feedback es claro: quieren que todo sea más simple. En eso estamos.
Tibo
·
4 oct, 04:35
♥ 664
Lo que hizo - eliminar todas las categorías de correo que no necesitaba conservar, validándolas en lote - identificar etiquetas para los tipos de trabajo que hago y clasificar todos los correos de forma apropiada - guiarme por los correos que necesitaban respuesta, buscando contexto relevante en segundo plano para responder bien Y en el proceso pude revisar mucho del feedback y las solicitudes que la gente me manda directamente al correo. Fue un buen sábado.
Tibo
·
4 oct, 04:30
♥ 3 mil
Nunca en mi vida había llegado a inbox zero hasta que se lo puse como meta activa a mi dot para que me ayudara a lograrlo. A ver cuánto dura, pero se siente genial.
poteto
·
4 oct, 00:32
♥ 82
además, dr eggbot también puede ayudarte a crear un bot de ingeniería de alta calidad que usa pstack para todo su trabajo!
poteto
·
4 oct, 00:31
♥ 4,4 mil
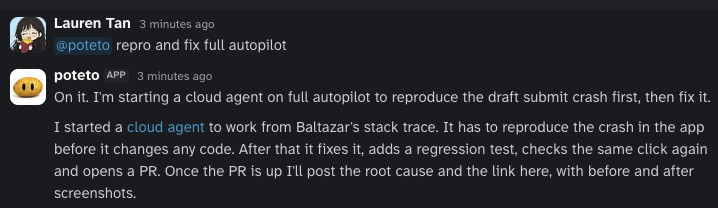
es fácil caer en la trampa de microgestionar a tus agentes en lugar de corregir el entorno que moldea su comportamiento. pstack 0.15.9 ahora trae una nueva skill /correct: si sigues corrigiendo a los agentes por los mismos errores, encuentra el patrón y lo arregla con arquitectura, tipos y checks. me gusta imaginar que los commits que entran a toda velocidad al codebase son como un bonsái creciendo rapidísimo hacia donde se le antoje. lo que quieres no es rendirte ante el caos, sino domarlo a propósito con las restricciones correctas 0.15.9 también trae mejoras en: • /architect: ahora incluye instrucciones para diseñar una arquitectura amigable para agentes • una nueva skill /benchmark-checklist basada en la checklist de benchmarking de @brendangregg aquí va un prompt que le puedes dar a grok bot para empezar a diseñar un mejor codebase con pstack: /poteto-mode crea un nuevo Project agent para refactorizar y rediseñar la arquitectura de mi repo para que sea más amigable para agentes. debe usar las skills /correct y /architect para revisar commits anteriores y encontrar los errores más comunes en los que caen los agentes, ya sea de calidad de código, rendimiento o bugs. si aplica, también puedes usar la skill /recall para encontrar conversaciones pasadas como contexto. debe hacer un plan de alto nivel para que yo lo revise. también debe responder sus propias preguntas abiertas haciendo prototipos en vez de dejármelas a mí. vuelve conmigo con un plan respaldado por datos reales. cuando apruebe el plan, usa el playbook stack o full autopilot (pregúntame cuál quiero) para ejecutarlo
poteto
·
3 oct, 05:08
1:05:36
LIVE: Poteto (creator of pstack) on shipping 1,000's of PR's a month at SpaceX
▶ YouTube · Matt Pocock
poteto
·
1 oct, 08:35
♥ 79
oye @bot avísame cuando esté listo me voy a dormir
poteto
·
1 oct, 08:33
♥ 983
Le di mi cerebro a mi bot, así sabe exactamente lo que quiero. Así arreglo bugs ahora.
septiembre de 2026
poteto
·
27 sept, 13:00
45:04
We Built Grok Bot. Here Are Our 14 Best Bots | Peng Zheng & Lauren Tan
▶ YouTube · Peter Yang
Tibo
·
9 sept, 15:56
1:14:22
Building Codex with Tibo Sottiaux
▶ YouTube · The Pragmatic Engineer
agosto de 2026
Tibo
·
24 ago, 18:11
44:28
How to Understand the Next Wave of AI Before Everyone Else | Tibo Interview
▶ YouTube · Matthew Berman
poteto
·
13 ago, 22:00
28:41
Are Agents About to Replace Software Engineering? | Lauren Tan and Roshan Sadanani
▶ YouTube · MTS
junio de 2026
Tibo
·
22 jun, 17:57
39:33
The New Shape of Engineering
▶ YouTube · Datadog
mayo de 2026
Tibo
·
22 may, 15:30
31:08
Head of ChatGPT & Codex: agents for normal people are HERE
▶ YouTube · Silicon Valley Girl
Tibo
·
14 may, 20:28
43:03
Codex for Everyday Work: AI Agents Beyond Coding
▶ YouTube · OpenAI
Ver la cronología completa →